RL概论学习笔记
RL概论
视频网址:李宏毅 强化学习 (Reinforcement Learning, RL) 2021_哔哩哔哩_bilibili
What is RL?
解决的问题
收集标注很难,找不到最佳的解决方法
如何实现
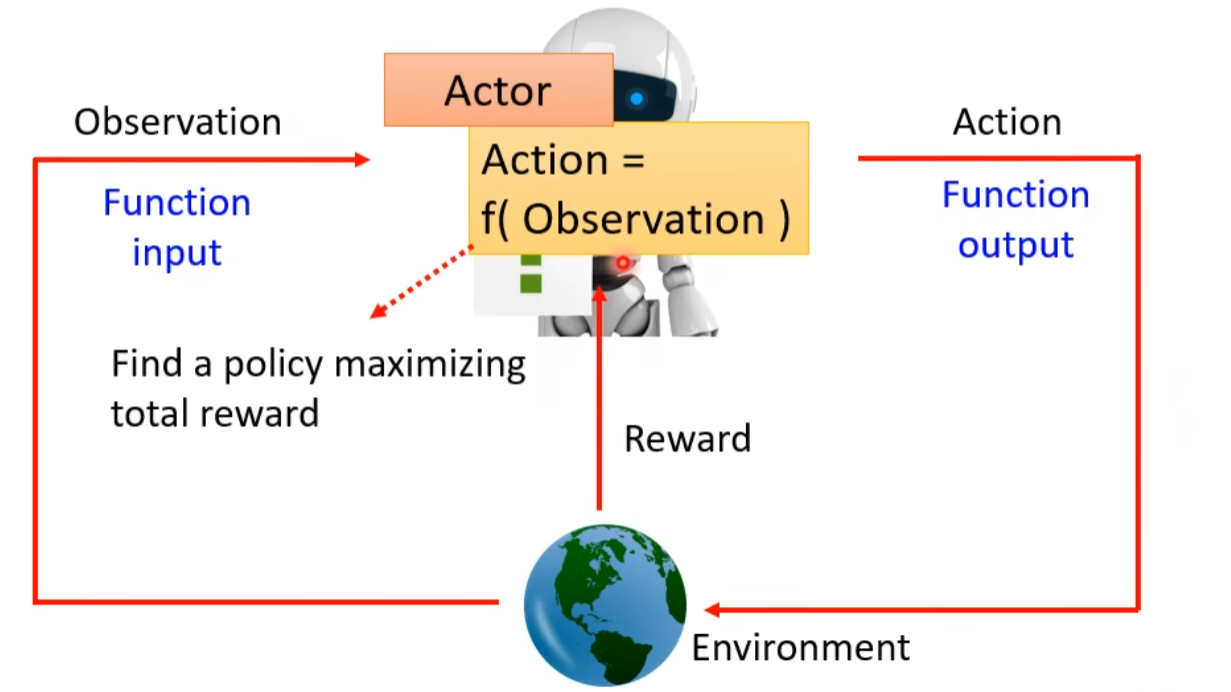
RL跟ML三步的关系
Step1 —— Function with unknown 定义Actor
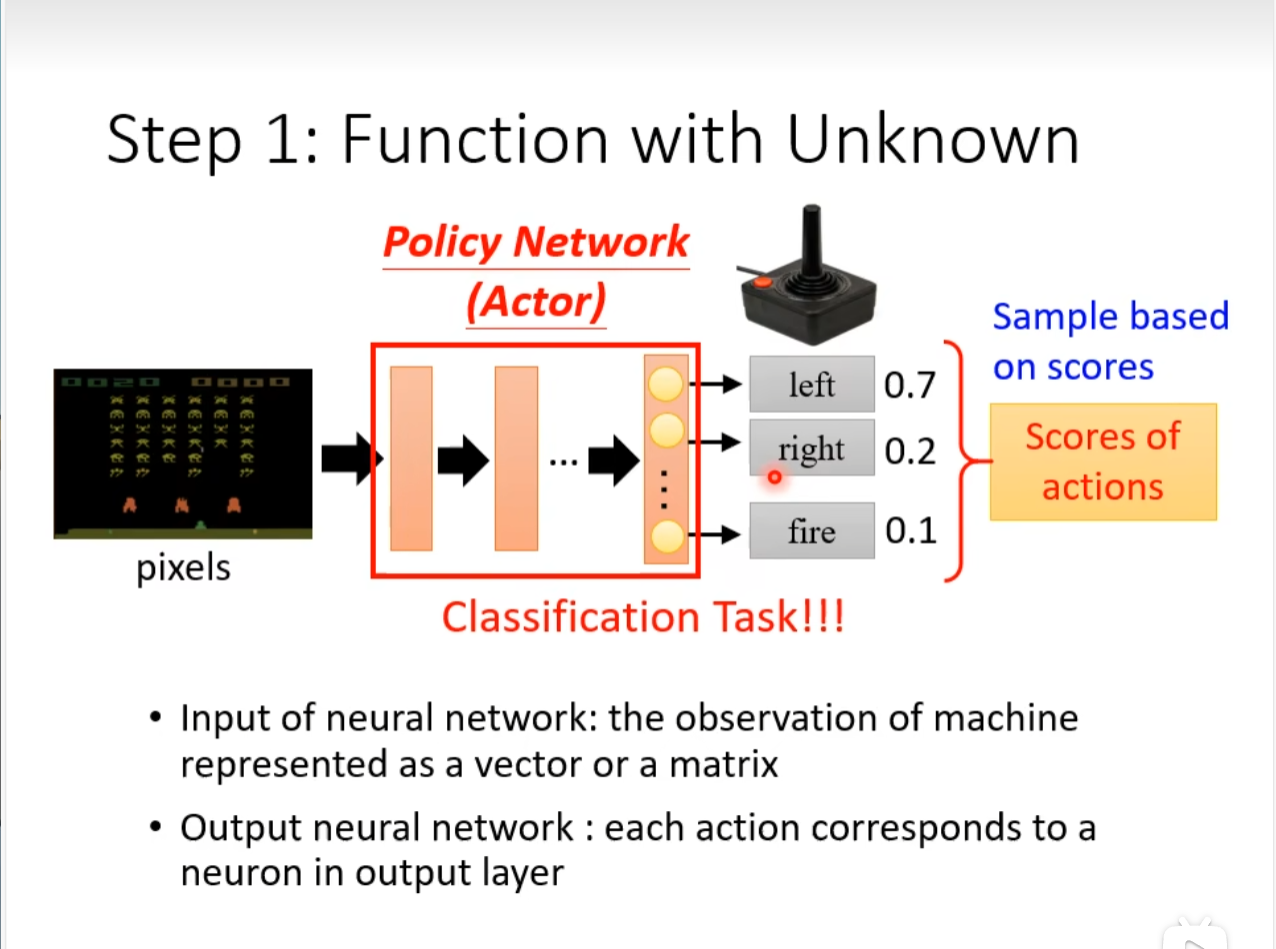
Input:复杂的输入(画面)
Actor:以往是简单的table,现在一般是network
Output:能进行的操作(Classification Task) 多少采取随机Sample 而不是直接取最大值作为这一步操作
Step2 —— Define “Loss”
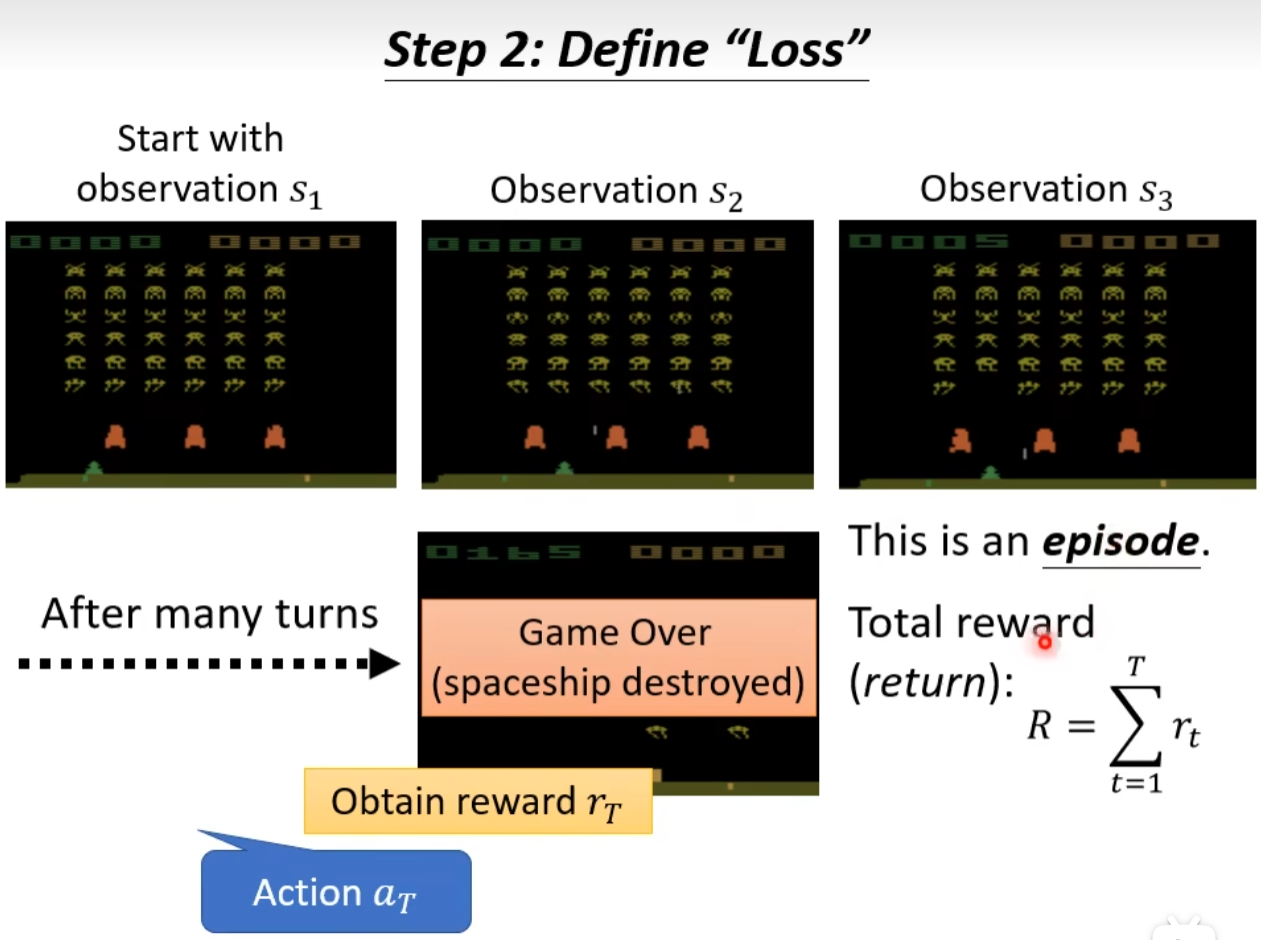
episode:一个游戏过程
Total reward(return):$R = \sum{r_t}$ (单个episode等到一个$r_t$) ——> 去最大化
Loss可以看作负的Total reward
Step3 —— Optimization
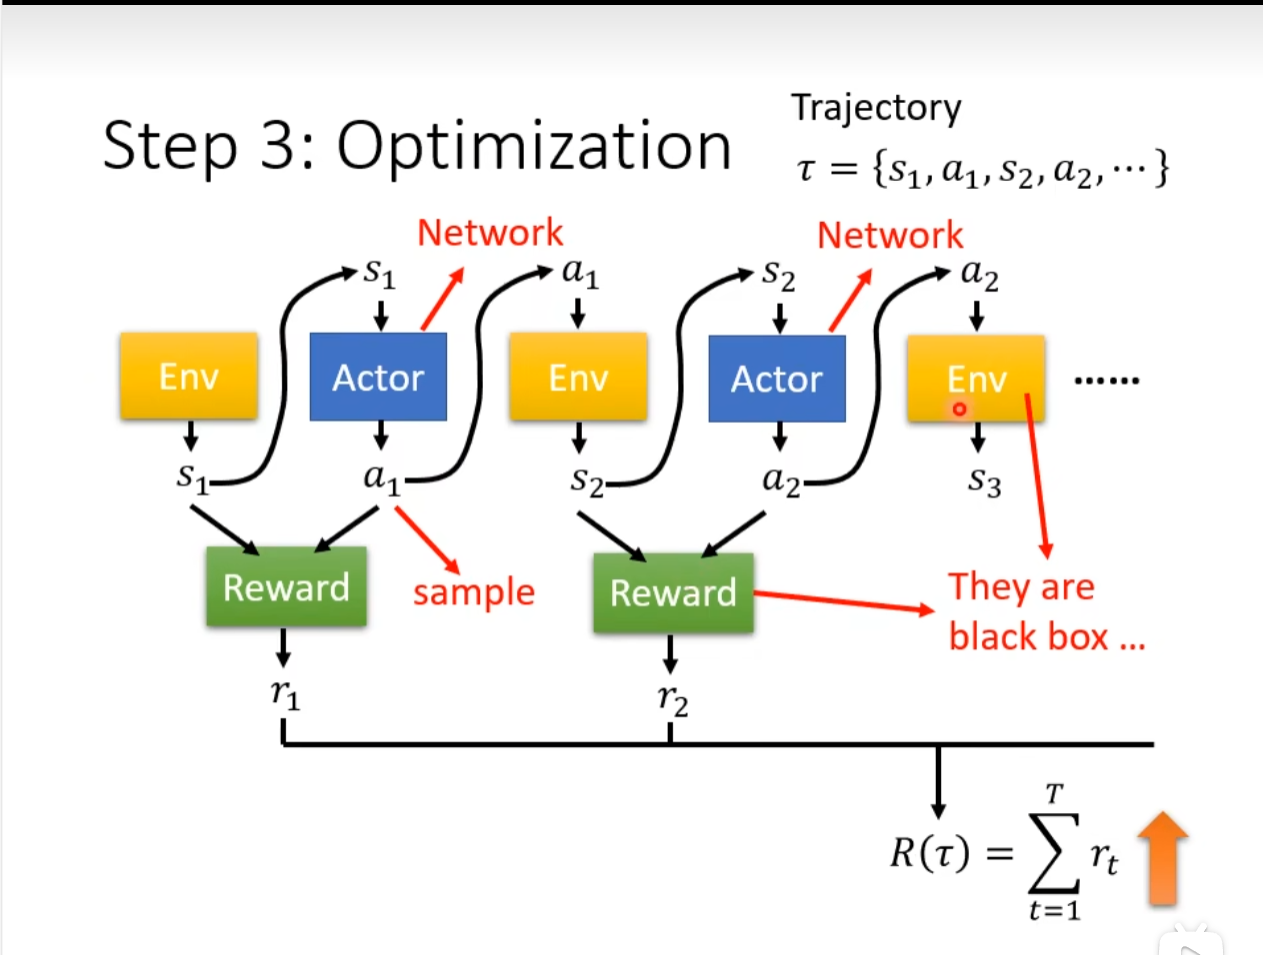
找一个Actor参数,让 $R(t)$ 越大越好
Policy Gradient
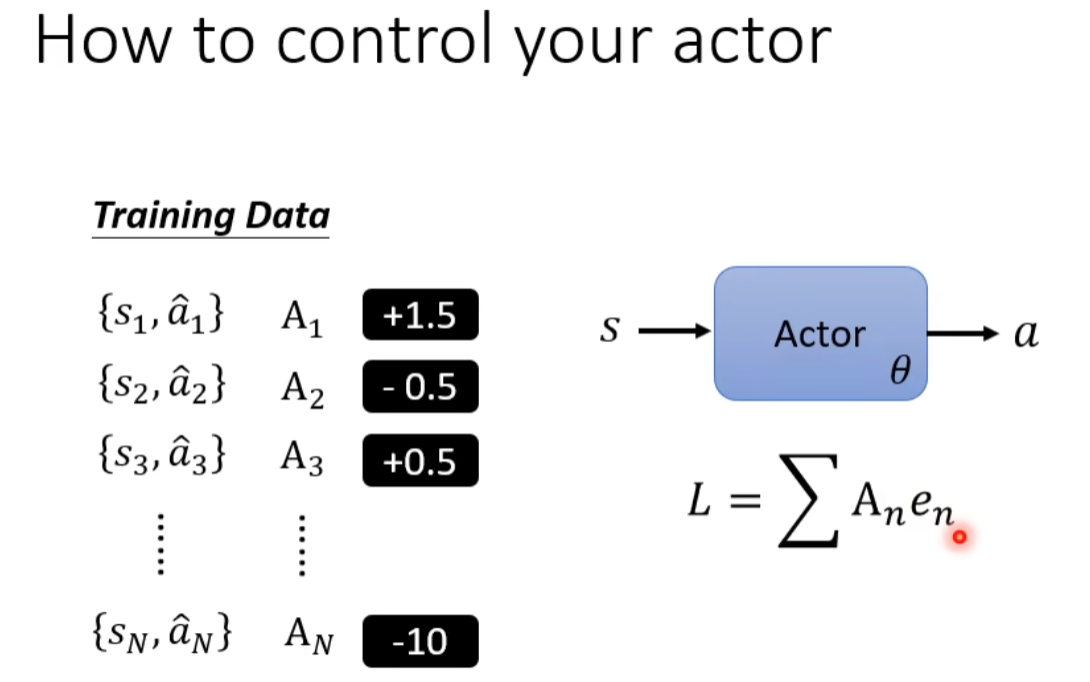
需要收集一些数据,指定有些行为希望他执行,有些希望不希望他执行
Reward delay:需要牺牲一些短期reward去得到长期更多的reward
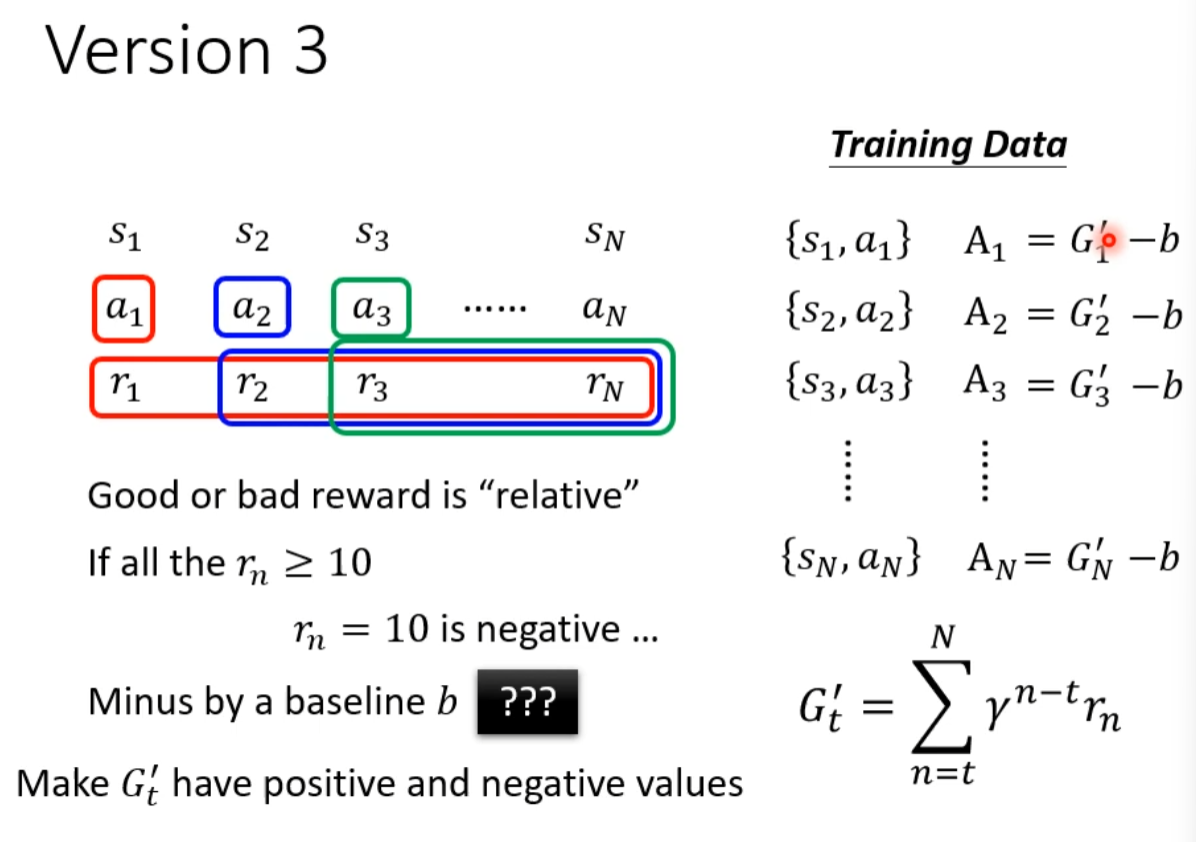
一个操作的Reward:从目前到结尾的收益加权累加,并减去baseline
不同的RL很多在 $A_{i}$ 的定义上下文章
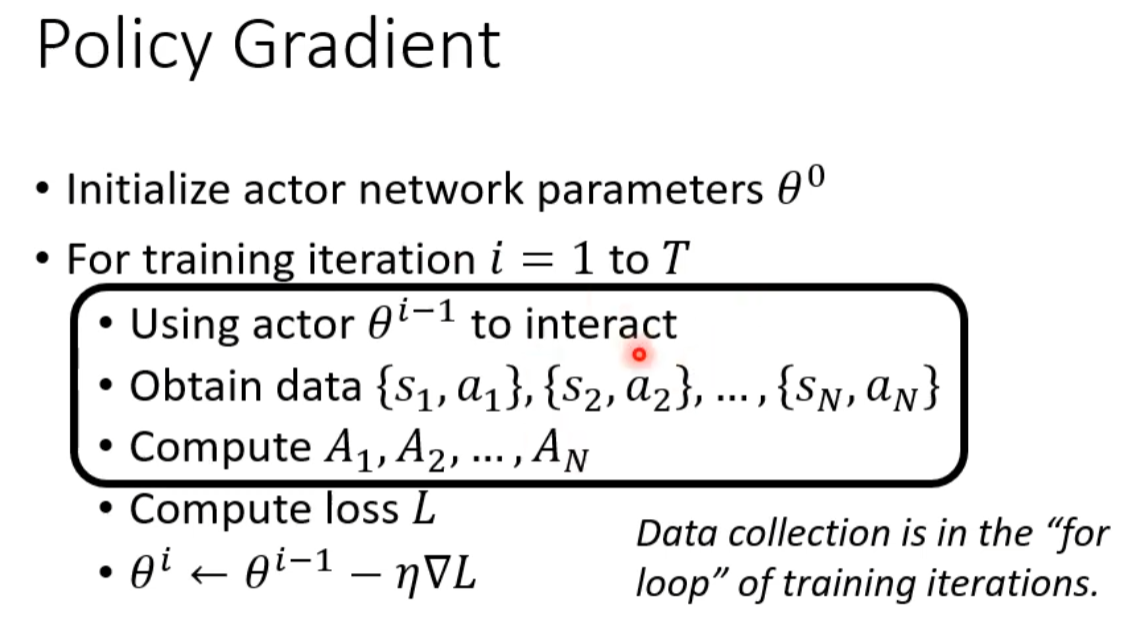
每一次epoch都要收集一次data,这里开销很大
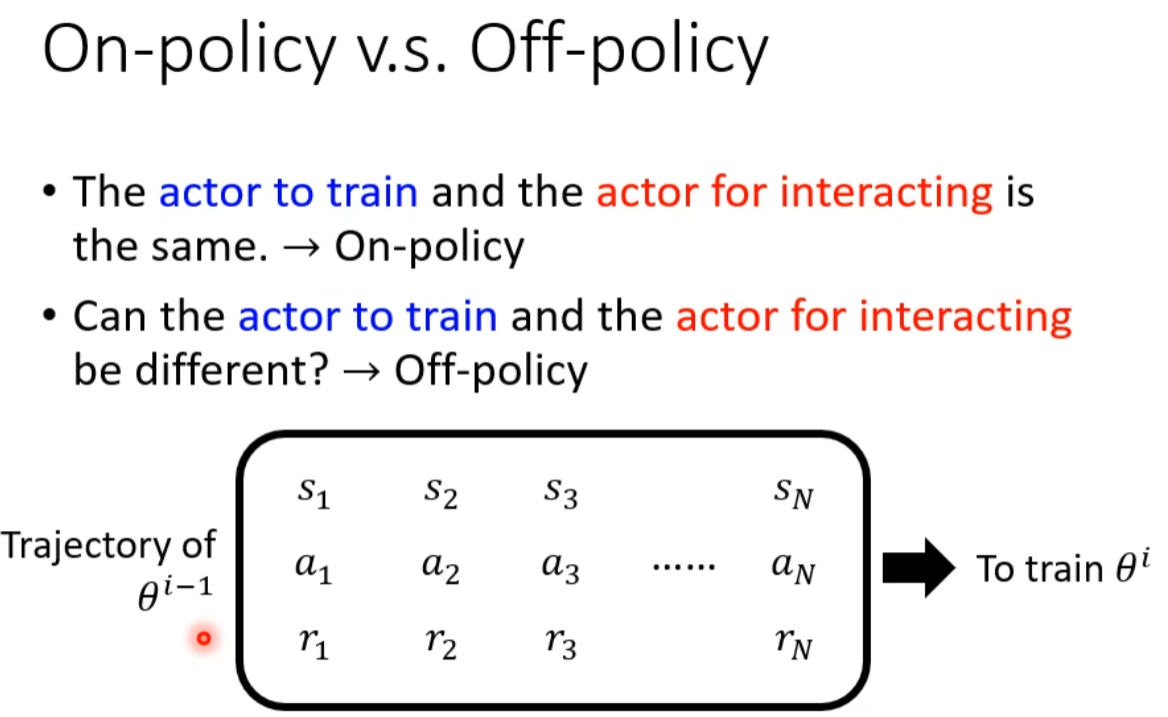
Off-policy 能用一些方法,用 $\theta^{i-1}$ 的资料训练 $\theta^{i}$ ——> PPO (要能知道actor to train跟actor to interact的差距)
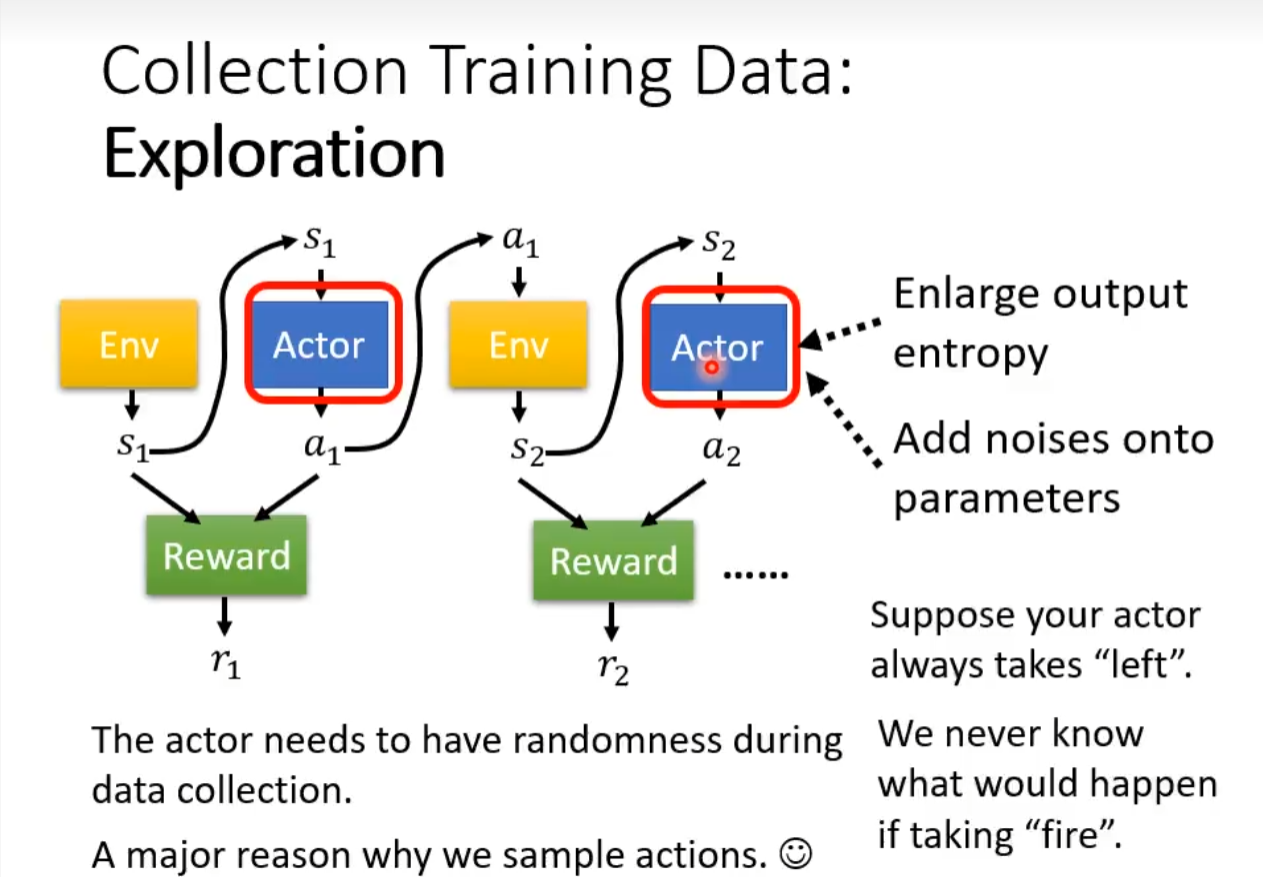
Exploration:收集数据的过程要有随机性——> 收集到比较丰富的资料。
可以加大没随机到的概率;直接加noise
Actor-Critic
Critic:评估Actor的好坏
Value function $V^\theta(s) $: 看到s后,用 $\theta$ 作为Actor操作后得到的discounted cumulated reward 是多少
如何训练 Value function
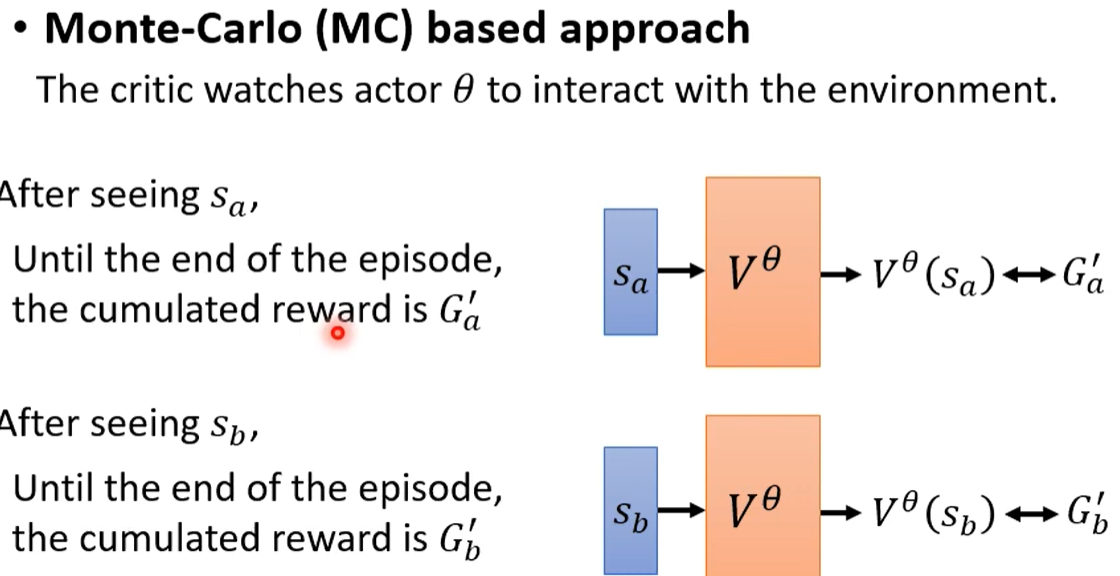
蒙特卡洛(MC)方法:直接观察玩完 $s$ 得到的 cumulated reward,然后与其逼近
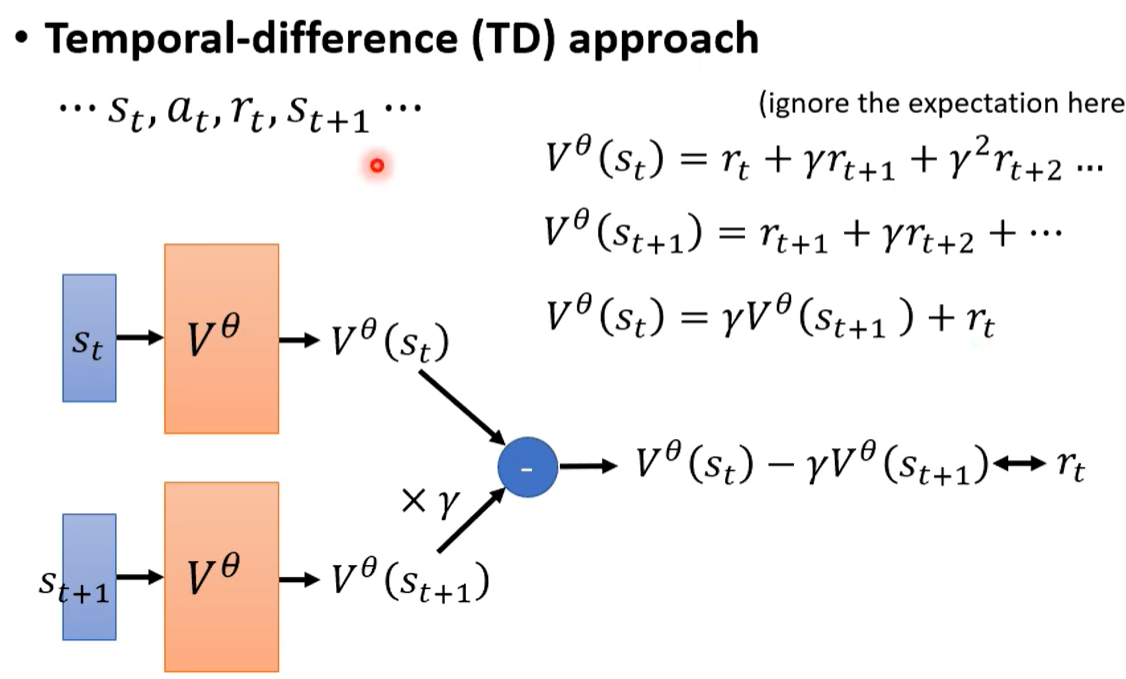
Temporal-difference(TD)方法: 收集到 $r_t$ 后,直接通过自己这一项和下一项 * $\gamma$ 的差值去逼近(好处:不用玩完游戏,适合游戏时间较长的游戏 )
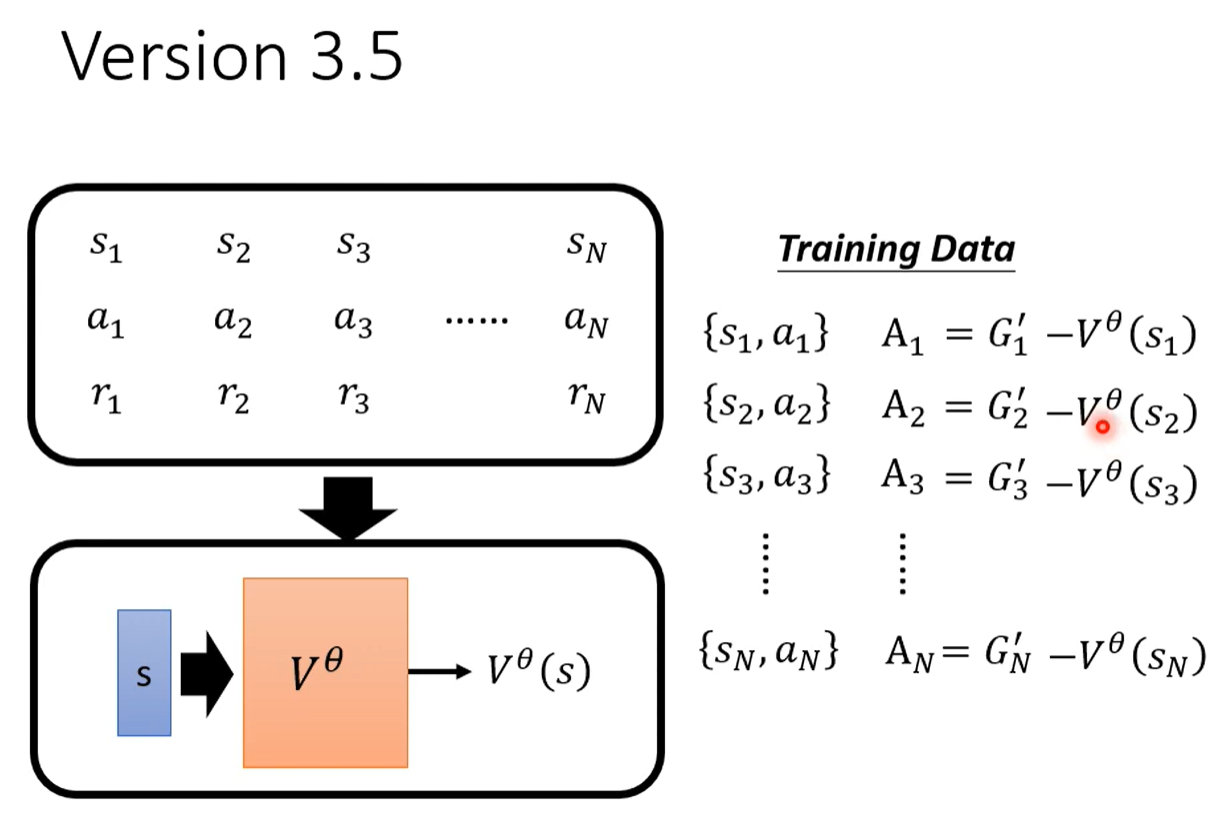
一个方法是将baseline设为 $V^{\theta}(s_1)$ 然后将当前得到的 数据 $G^{‘}_{t}$ 与 其做差查看好坏
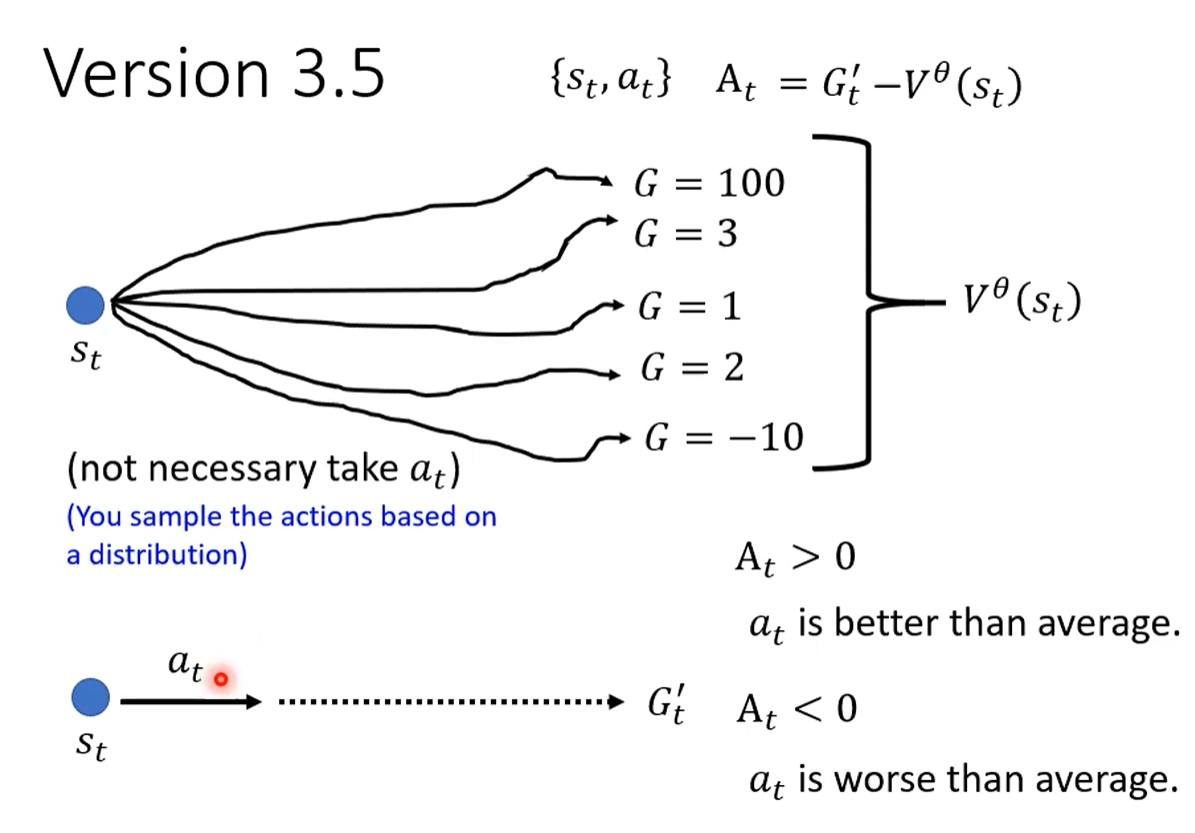
Advantage Actor-Critic
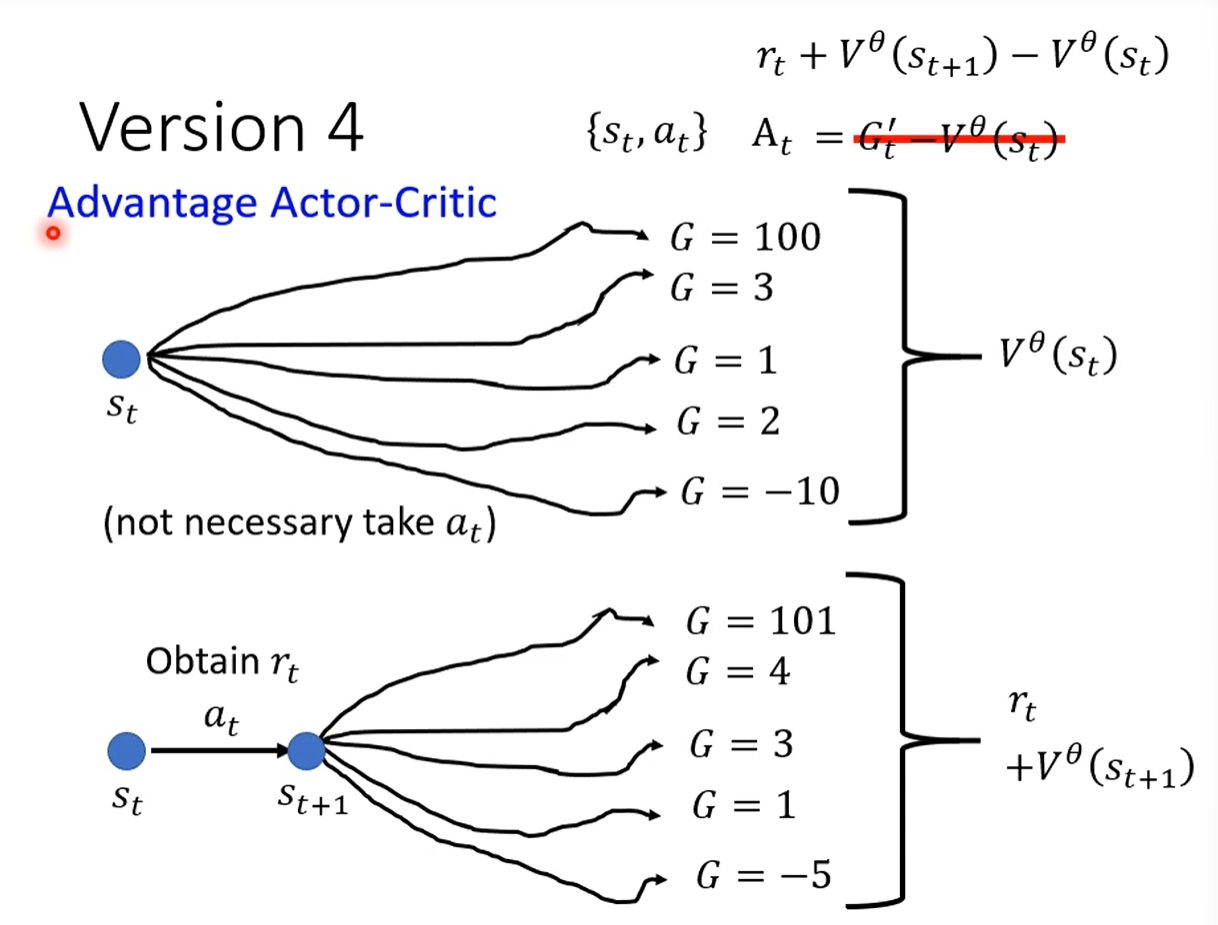
将 执行过操作 $a_t$ 得到的reward(图下方) 与 随机抽样得到的reward 比较,如果大于则认为较好,否则认为较差。
DQN
待深入了解
Reward Shaping
如果多数的reward都是0怎么办 ——> 提供额外的reward去学习(Reward shaping)
就是通过人工加入规则外的reward(如射击游戏里浪费子弹就要扣分)——> 需要设计者对问题本身有足够的理解
Curiosity based reward shaping
要求agent看到新的东西,而且是有意义的新 就给他reward
No Reward: Learning from Demonstration
定义Reward的方式非常困难,没定义好Reward会出现很坏的情况
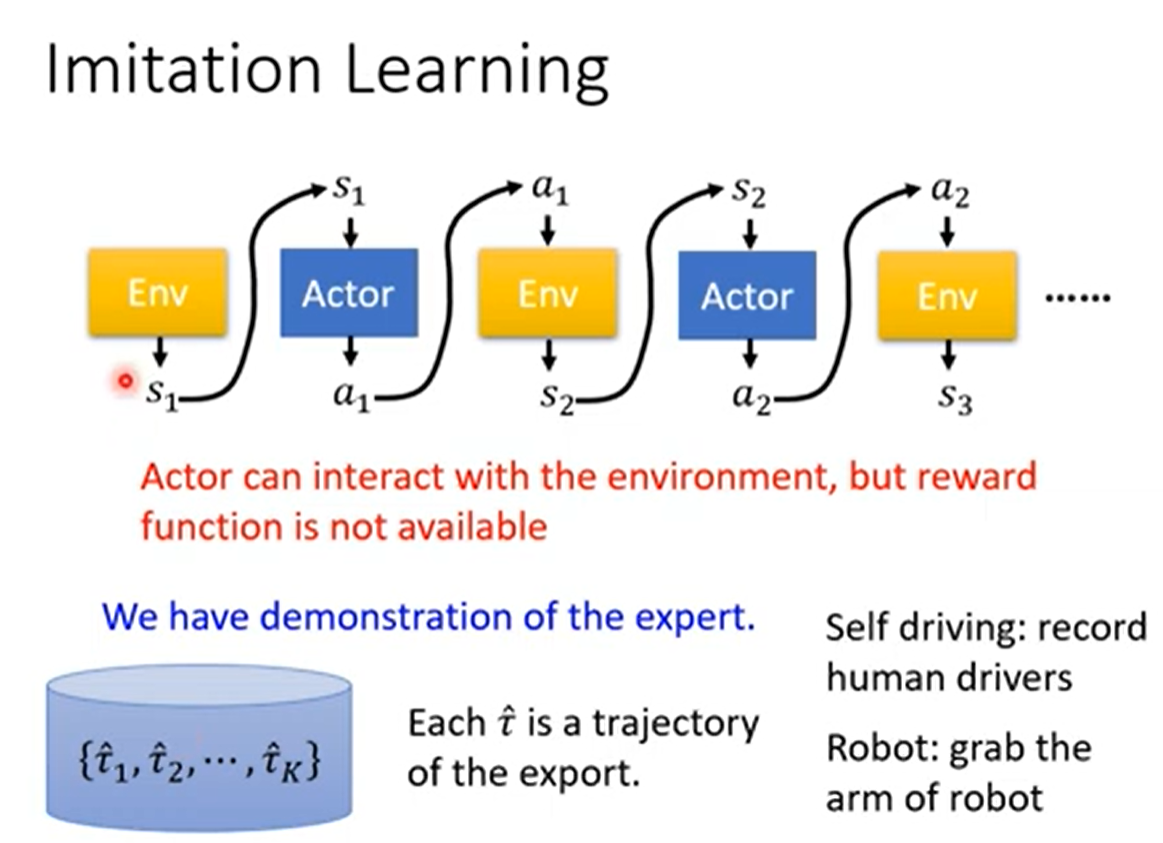
Imitation Learning 模仿学习
Inversed Reinforcement Learning
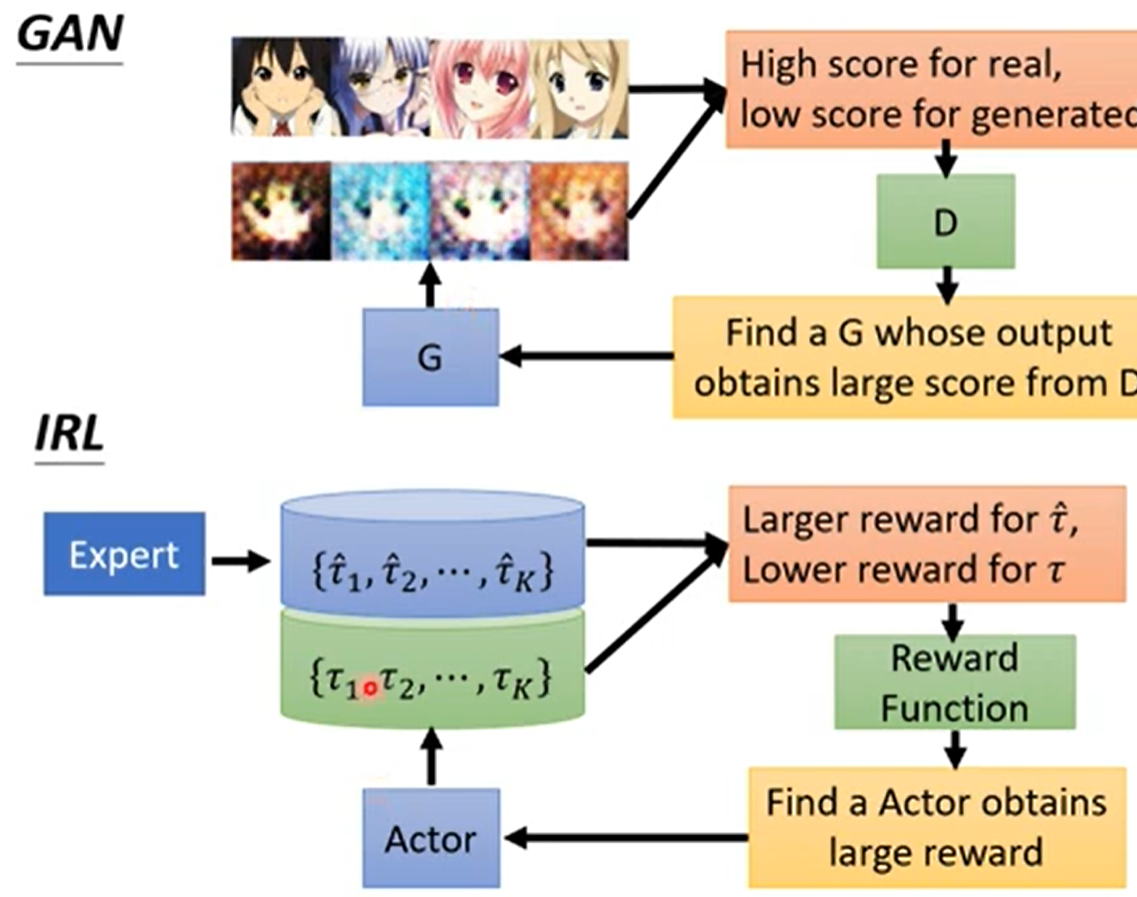
本来不知道reward,通过expert示范去反推Reward Function
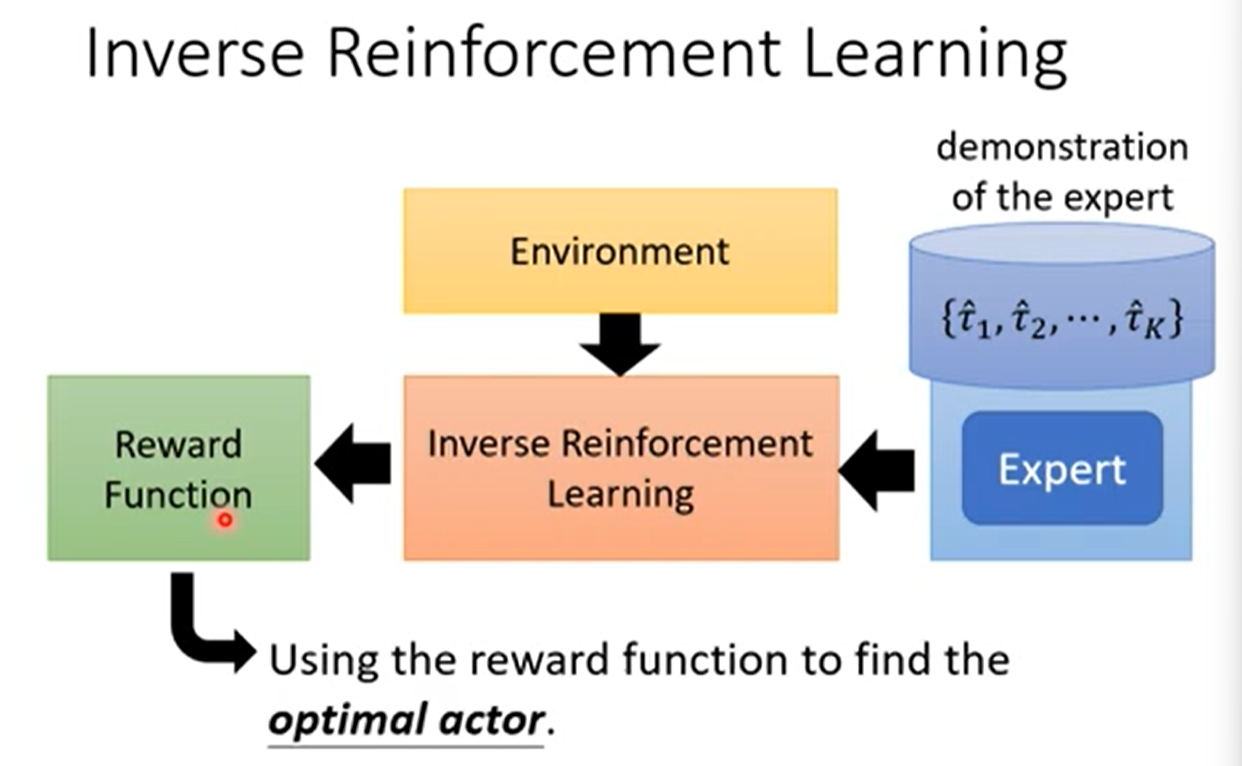
简单的Reward Function可能能训出复杂的actor
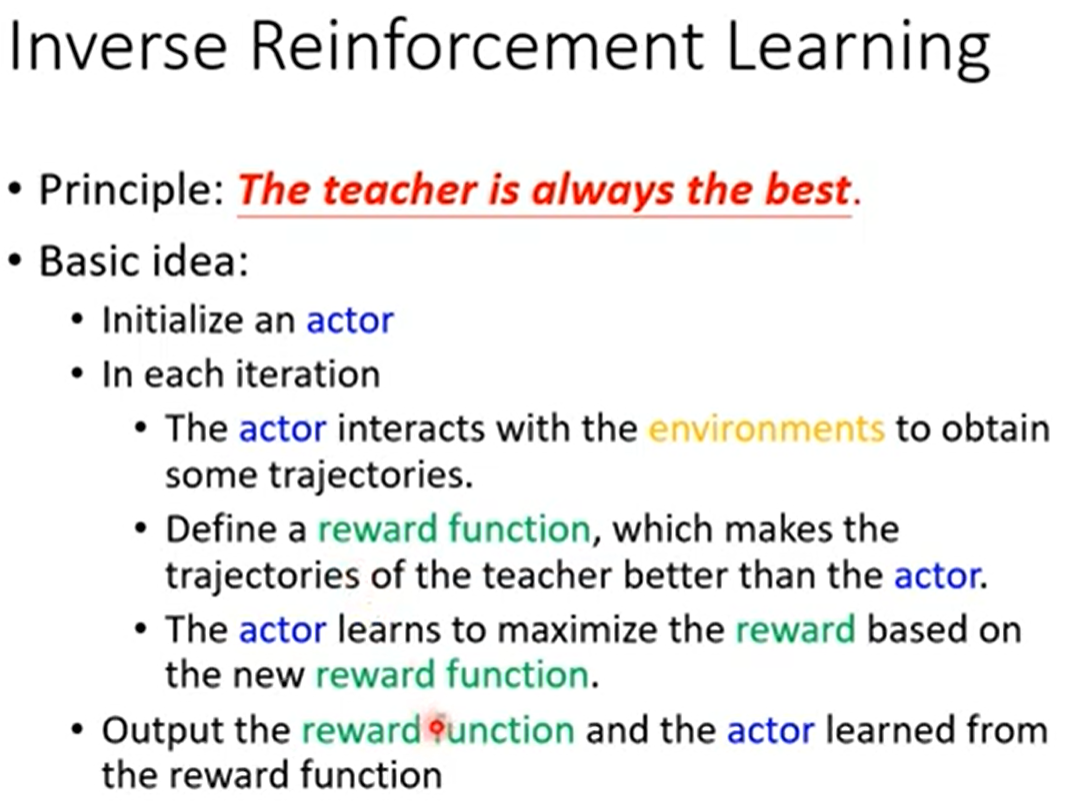
先获得一些数据,然后找到一个reward function让expert的reward高于现有的actor,再让actor在这个reward function上学习
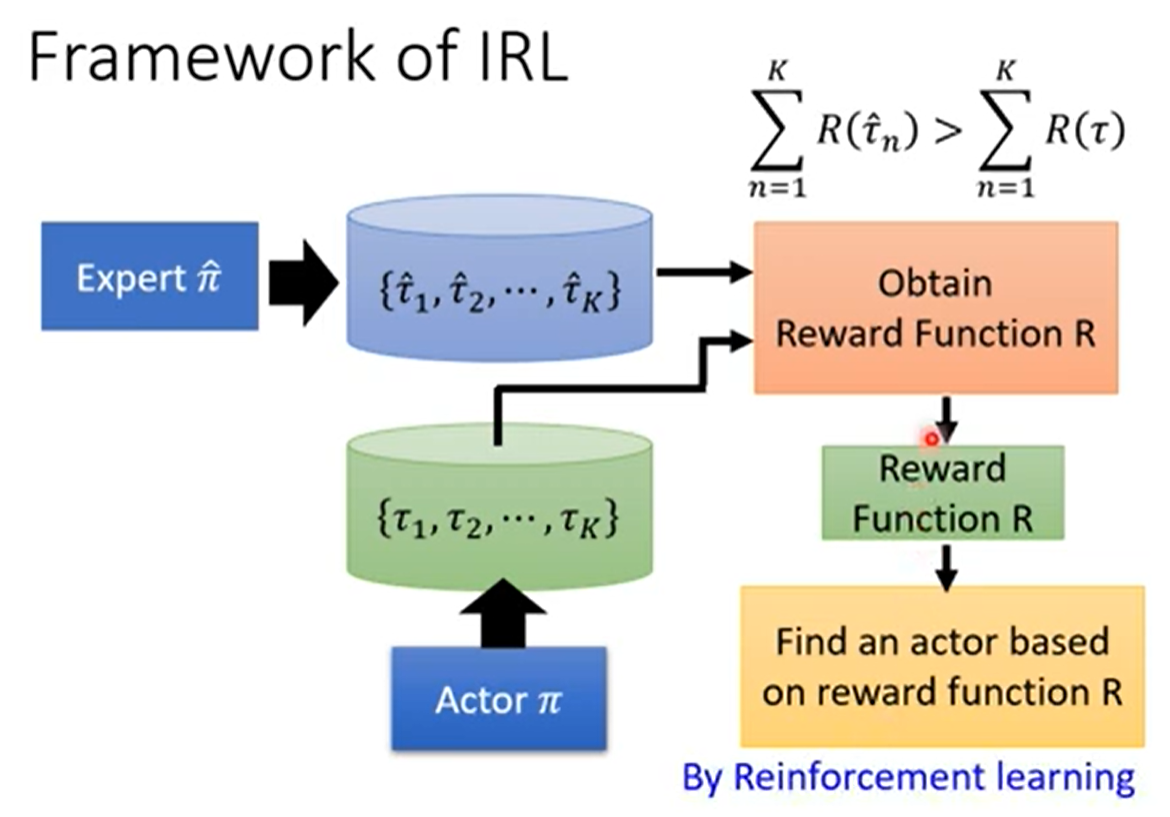
GAN VS IRL
框架类似