Transformer学习笔记
Transformer学习笔记
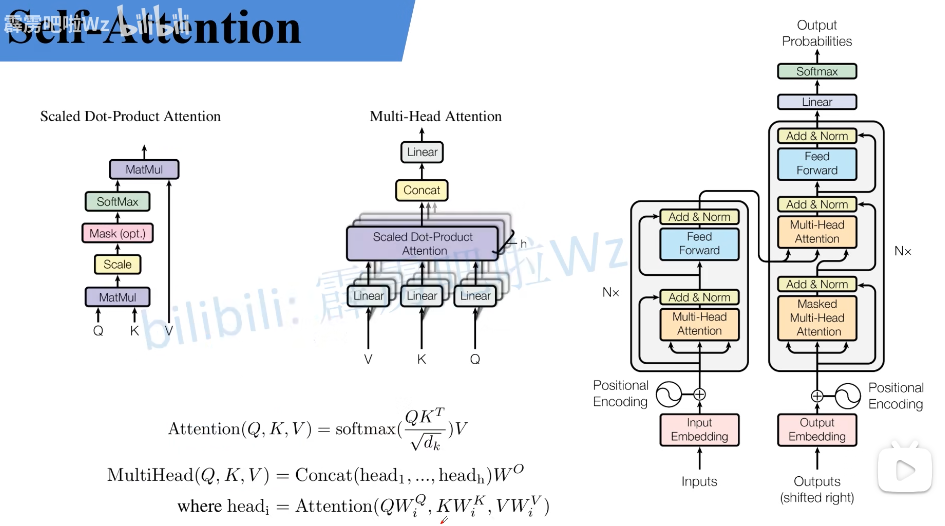
Self-Attention
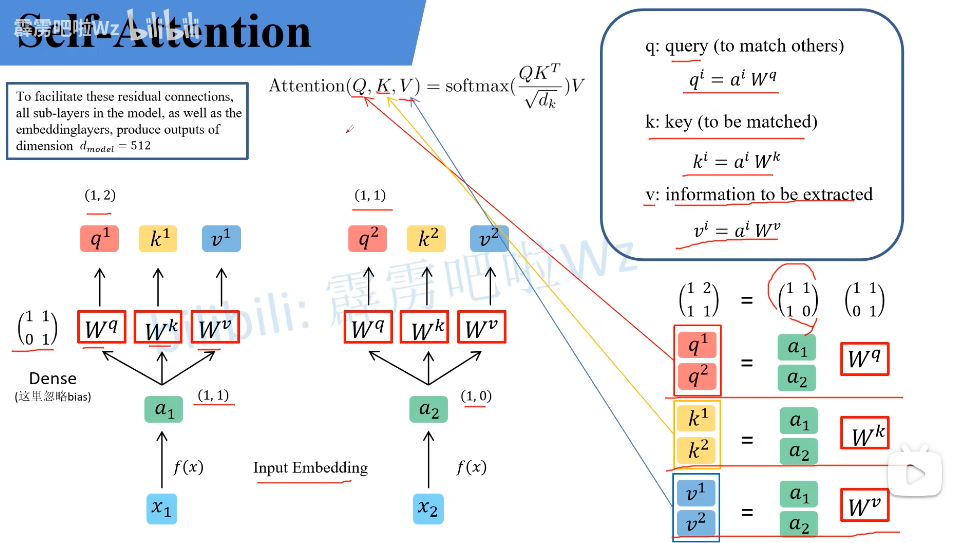
每个元素 $x_{i}$通过embedding得到 $a_{i}$ ,再通过 $a_{i}$ 乘上$W_{q},W_{k},W_{v}$ 得到 $q^{i},k^i,v^i$
$Q(query)$ : 去匹配每一个key
$K(key):$ 去被query匹配
$V(value)$ : 需要被提取走的信息(a当中学习到的信息)
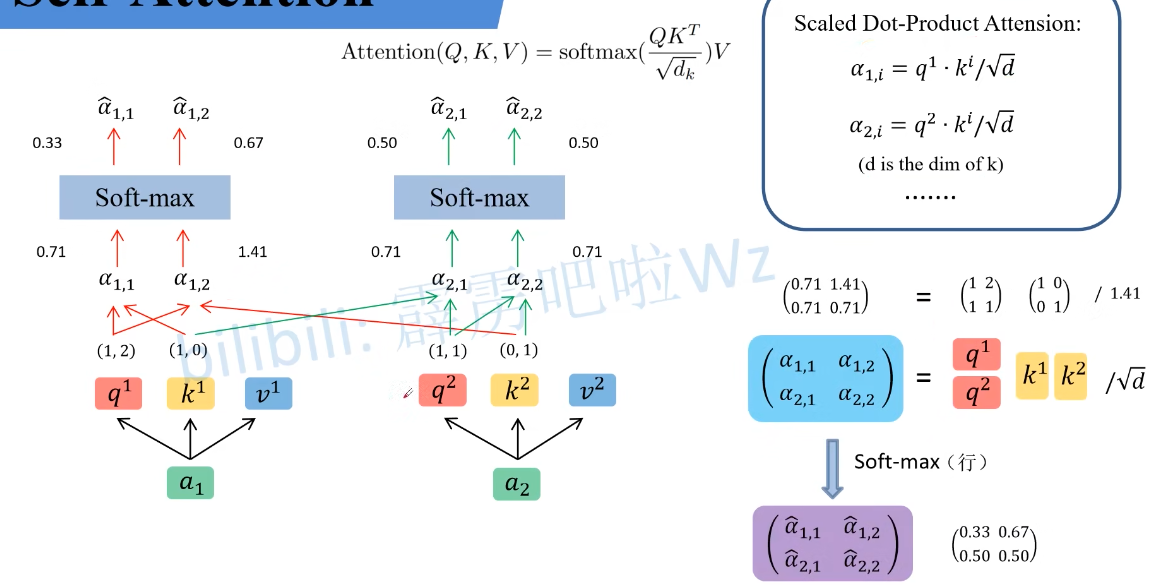
点乘:可以体现矩阵的相似度
缩放点积注意力(Scaled Dot-Prodect Attension)
$a_{1,i} = q^1 \cdot k^i / \sqrt{d}$
…
d 是 k 的维度
个人理解:$Q \cdot K$ 计算出相似度,然后通过softmax,算出每个元素与我($k^{i}$)的相关概率
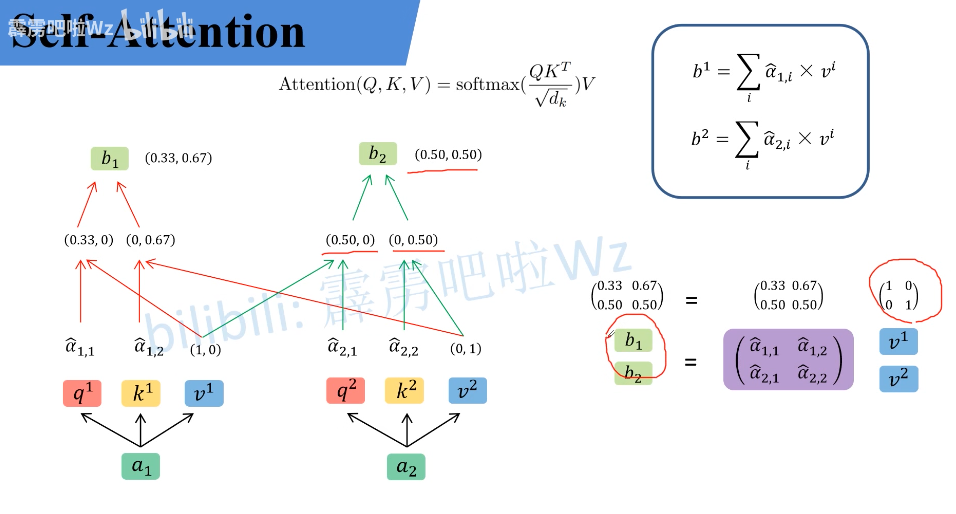
再通过这种相似概率($\hat a_{i,j}$) 乘以信息 $v_{j}$ 得到输出 $b_{i}$ ,
Multi-head Self-Attention
将 $q$ 进行拆分成 $q_{1,1} q_{1,2}…$
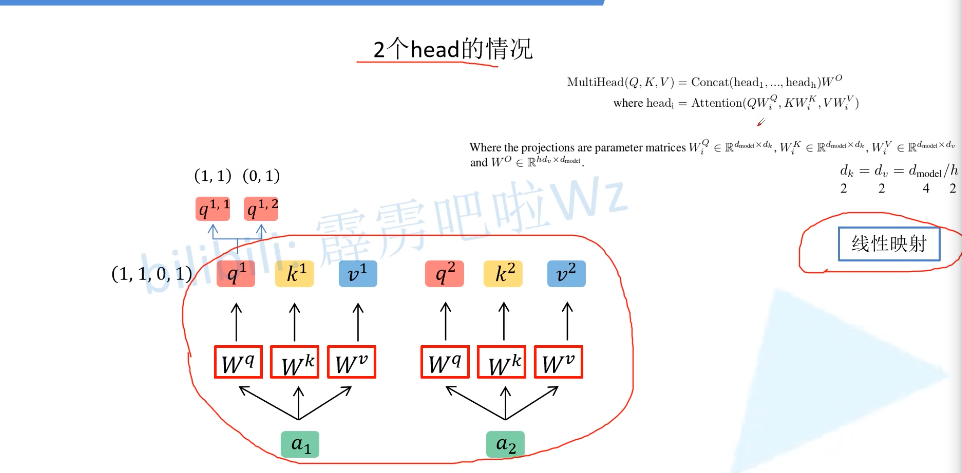
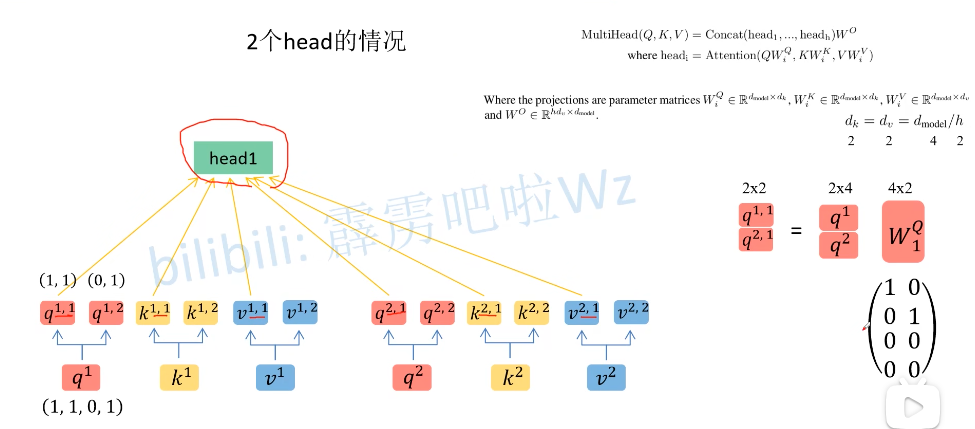
将其他参数也这样做,然后取出下标 $i$ 形成head $i$,获得多个注意力头
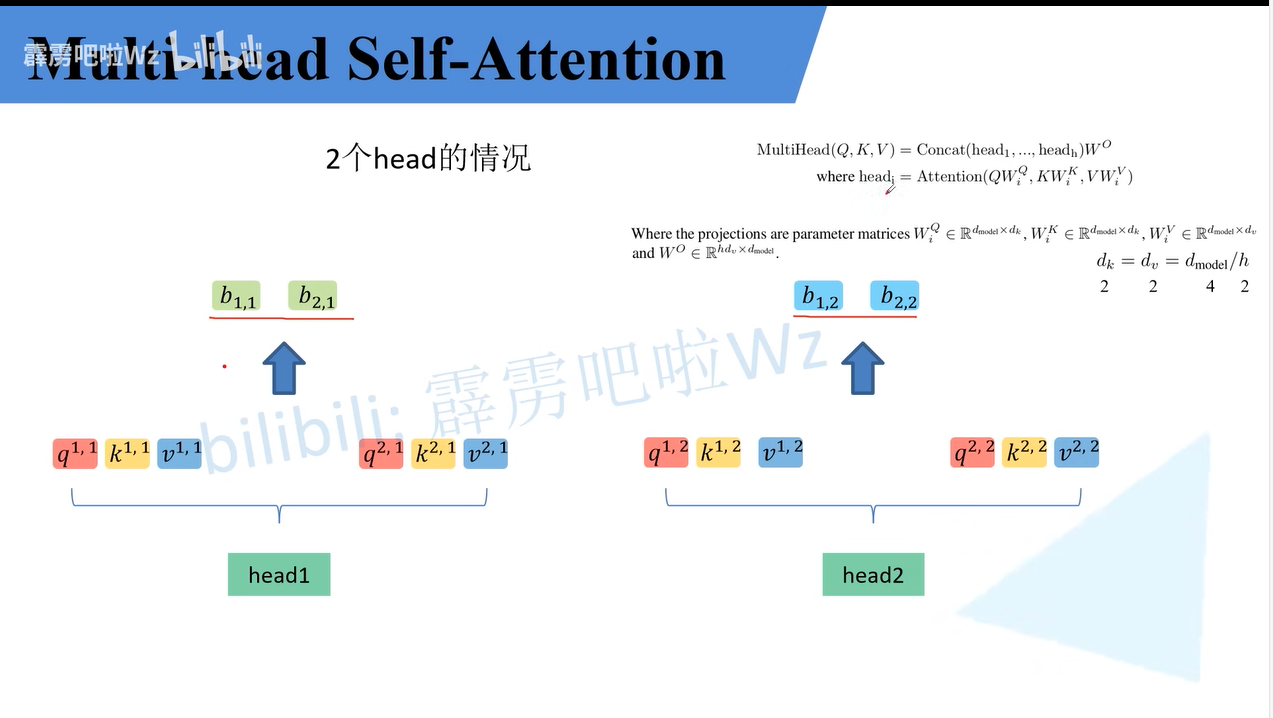
以此类推 所有同一种 $j$ 的 $q_{i,j},k_{i,j},v_{i,j}$ 生成一个 $b_{i,j}$ , 同一种 $j$ 的 $b_{j}$ 称为 head $j$
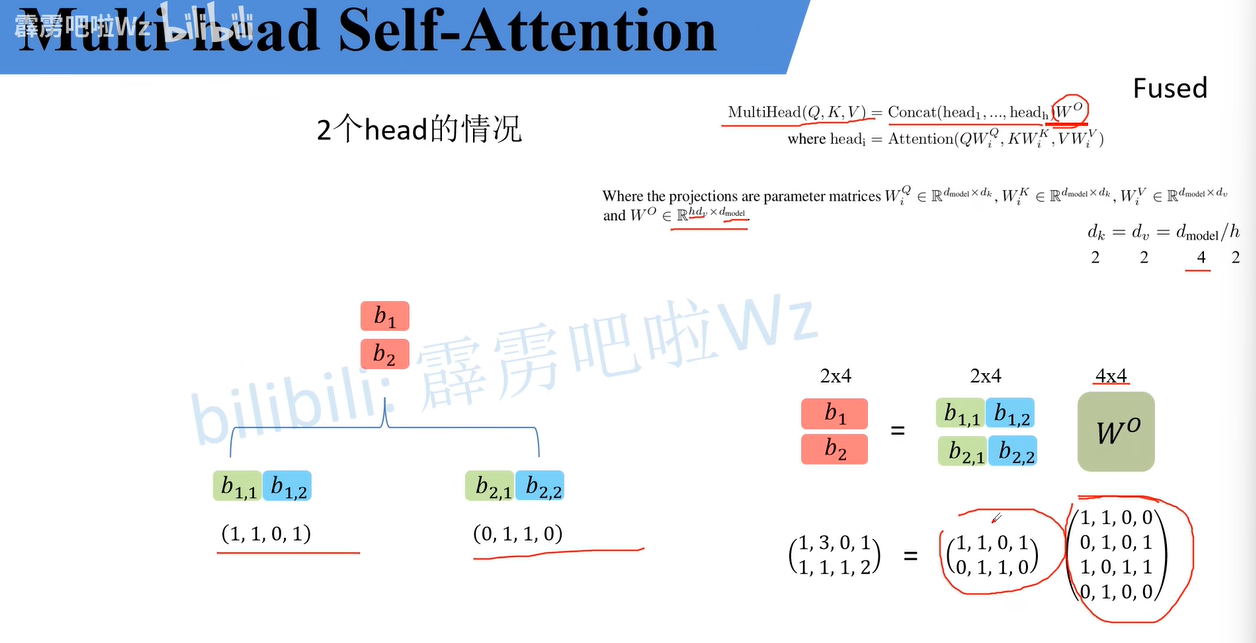
 将head进行拼接(Concat),通过 $W^{o}$ 进一步融合,得出输出
Positional Encoding
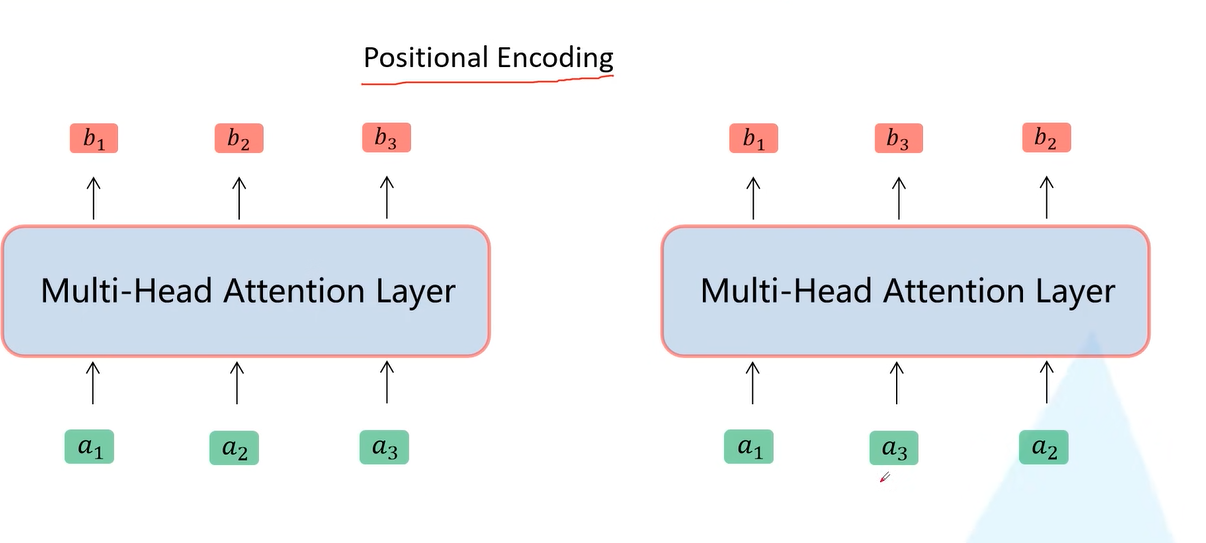
无序性(Permutation Invariance)
如果不对位置编码的话,在不同元素进行调换得出的结果是一样的
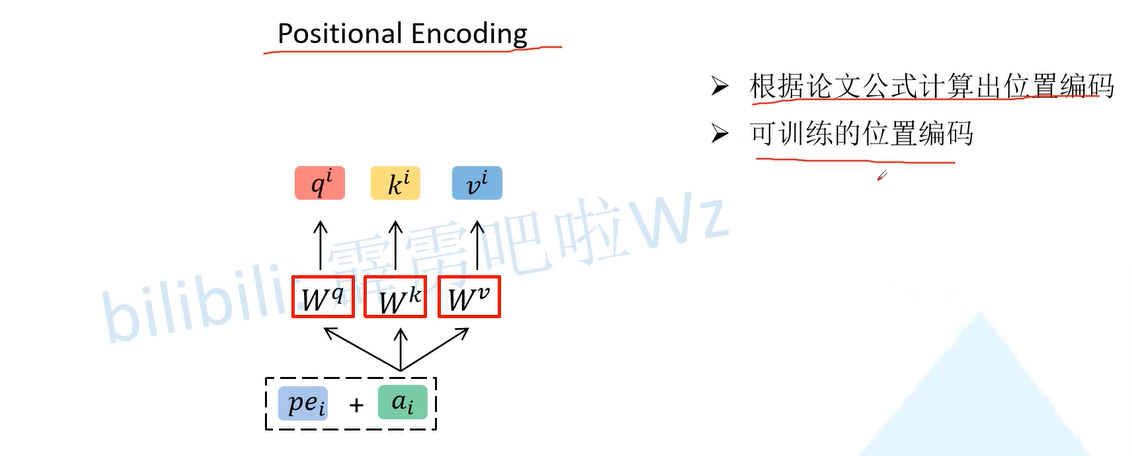
可以通过下图两种方法进行计算
Transformer学习笔记