论文笔记:CLIP
论文笔记:CLIP
论文原文:Learning Transferable Visual Models From Natural Language Supervision
视频导读:CLIP 论文逐段精读【论文精读】_哔哩哔哩_bilibili
特性:迁移性好,利用好自然语言的监督信号,训练规模大
CLIP理论
采用对比学习:将Image和Text编码,配对的为正样本,不配对的为负样本
为了让ImageNet的标签变成句子,通过 A photo of a {object} 这个prompt template 去形成句子,比单个标签效果好
ZeroShot实现:通过图片与文本算相似度的方式,去判断照片里有哪些物体
因为将图像的语义和文字的语义结合在一起,所有他学到的特征语义性强且迁移性好
Linear Probe(线性探测)
冻结骨干网络(Backbone),只训练分类头
如何做:在输出端构建一个全连接层,输出为想要的分类
为什么:计算效率快、避免灾难性遗忘、研究 Zero-shot vs Linear Probe 差距
CLIP方法
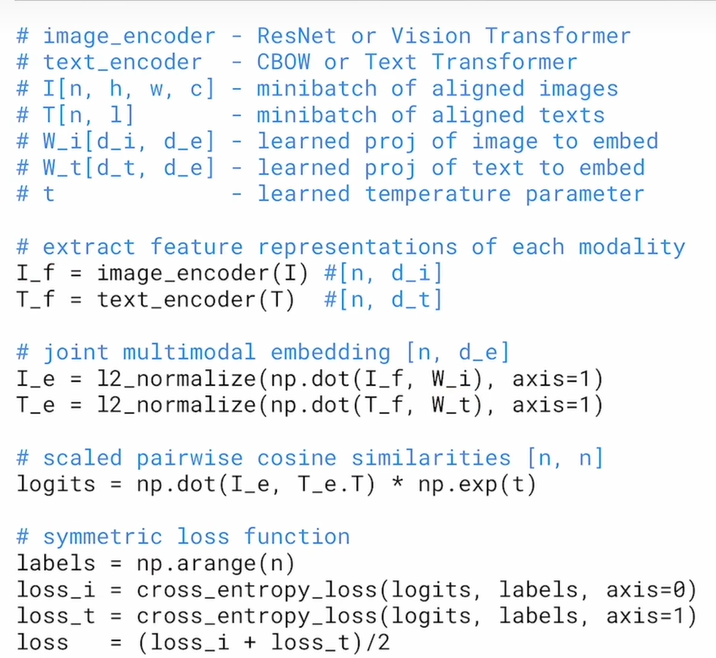
- 先对image和text进行编码
- 通过归一化将image和text投射到同一个空间里去(Embedding)
- 算出相似度
- 相似度跟ground truth计算交叉熵,计算出loss
EfficientNet 如何放大模型
- 深度 (Depth) $\times \alpha^\phi$
- 宽度 (Width) $\times \beta^\phi$
- 分辨率 (Resolution) $\times \gamma^\phi$
这里 $\alpha, \beta, \gamma$ 是固定的常数。改变 $\phi$ 去放大模型
CLIP实验
Zero-Shot Transfer
以前的学习是在学一些泛化性好的特征——> 还是要微调,会发生distribution shift
直接用又大又好的模型进行覆盖
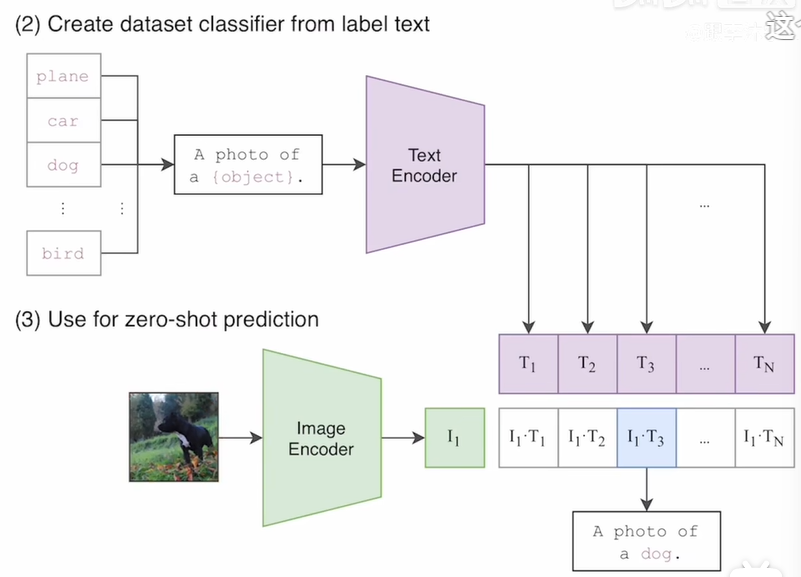
文本和图像编码embedding后直接算相似度,相似度最大的就是结果
Prompt Engineering and Ensembling
通过类似 A photo of a {label} 的样式,将单词变成句子减少歧义性,从而有更好的效果
启示:如果你预先知道一些有关信息,如知道这个数据集里的都是宠物,可以在构造的句子里加上,能缩小解空间,提升正确性
Zero-Shot CLIP Performance
对于特别难描述或者本身较难的任务(如数个数,纹理分类),以及特定领域知识的任务(如肿瘤分类),Zero-shot表现较差,需要few-shot。
Representation Learning
为什么不用fine-tune而是用Linear Probe
- 本身CLIP在研究跟数据集无关的预训练方式,微调后验证不了预训练模型的好坏(因为可能在微调过程中,预训练模型变强或者变差了),用Linear Probe学习空间就比较少。
- fine-tune要搜超参(比如大数据集要用大学习率,否则用小的)
CLIP 局限性
在一些任务上与当时SOTA有区别,能差上十几个点
虽然模型扩大还能提高正确率,但是扩大后训练代价太大
有些数据集如细分类,抽象概念等做的不好
在MNIST上表现差(数据集里几乎没有数字)
数据利用率低——> 可以做数据增强,自监督,伪标签的方法
无zero-shot数据集,会让研发有针对性(超参啥的)
提供oneshot,fewshot等情况下,可能还没有zeroshot好
伪标签 (Pseudo-Labeling):利用无标签数据 & 清洗脏数据(通过教师模型)
自监督学习(对比学习):除了图文对比,还可以有图图对比(数据增强后对齐)和掩码重建