prompt 学习笔记
教材:提示工程指南 | Prompt Engineering Guide
Prompt Engineering Guide | Prompt Engineering Guide
参考手册:Best practices for prompt engineering with the OpenAI API | OpenAI Help Center
导言
LLM设置
Temperature:温度越低,结果确定性越高。反之随机性越高。要获得基于事实的回答可以调低温度值。对于诗歌生成等创造性任务,则提高温度会更有帮助。
Top P:一种结合温度的采样技术,称为核采样。您希望获得准确且符合事实的答案,请将其设置为较低值。如果您希望得到更多样化的响应,请将其调高。
一般建议调整温度或Top P,但不要同时调整两者。
Max Length:指定最大长度有助于防止出现冗长或不相关的回复,并控制成本。
Stop Sequences:停止序列是一个能让模型停止生成令牌的字符串。例如,你可以通过添加“11”作为停止序列,让模型生成不超过10项的列表。
Frequency Penalty:频率惩罚会根据某个 token 在响应和提示词中已出现的次数,对下一个 token 施加成比例的惩罚。以用来减少模型响应中词语的重复。
Presence Penalty:会对重复的标记施加惩罚,但与频率惩罚不同的是,所有重复标记的惩罚力度是相同的。出现两次的标记和出现10次的标记会受到相同的惩罚。可防止模型在回应中过于频繁地重复短语。
一般建议调整频率惩罚或存在惩罚,但不要同时调整两者。
基础知识
我们可以将prompt格式化成QA格式,这在许多问答数据集中是标准的:
1 | Q: <Question> |
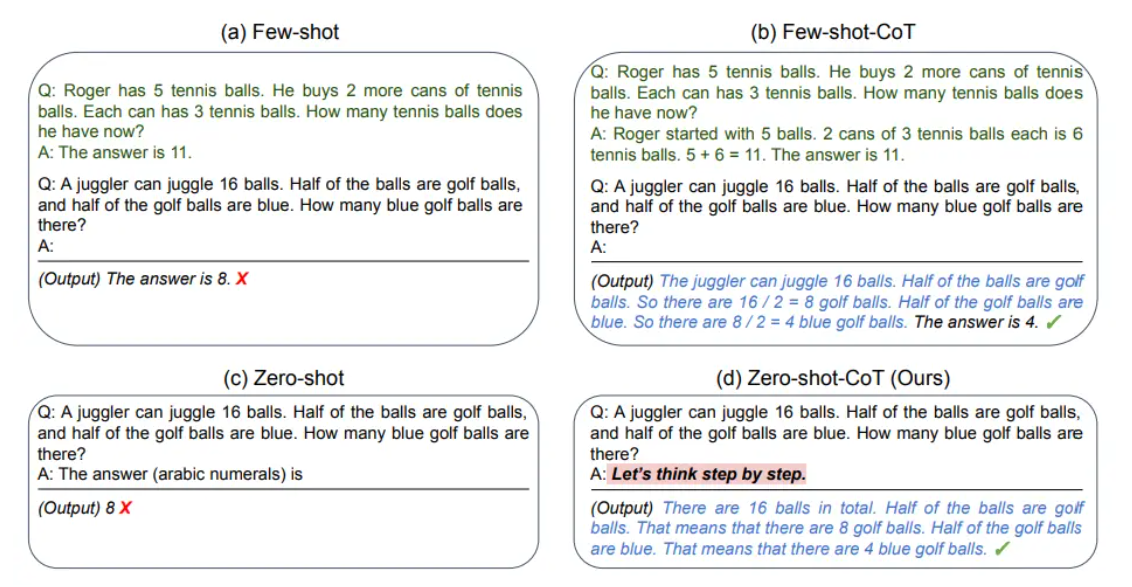
零样本提示 :直接提示模型进行响应,而没有提供任何关于你希望它完成的任务的示例或演示。
少样本提示:即提供示例(也就是演示)。你可以按以下方式设置少样本提示的格式:
1 | Q: <Question>? |
能实现上下文学习,即语言模型通过少量示例就能学习任务的能力。我们将在后续章节更深入地讨论零样本提示和少样本提示。
提示词的要素
提示词包含以下元素:
- **指令 **- 您希望模型执行的特定任务或指令
- 上下文 - 能够引导模型做出更好响应的外部信息或附加背景
- 输入数据 - 我们希望得到响应的输入或问题
- 输出指示 - 输出的类型或格式
设计提示词的通用技巧
从简单开始
当你开始设计提示词时,要记住这实际上是一个迭代过程,需要大量实验才能得到最佳结果。
可以从简单的提示词开始,然后随着你追求更好的结果,不断添加更多元素和上下文。明确性、简洁性和精炼性往往能为你带来更好的结果。
当你有一项包含许多不同子任务的大型任务时,你可以尝试将该任务分解为更简单的子任务,并在获得更好结果时不断完善。这可以避免在一开始就给提示词设计过程增加过多复杂性。
指令
你可以通过使用指令来告诉模型你想要达成的目标,从而为各种简单任务设计有效的提示词,例如“撰写”“分类”“总结”“翻译”“排序”等。通常,上下文与你要执行的任务越具体、越相关,效果就越好。
一个建议你将指令放在提示词的开头。另一个建议是使用一些清晰的分隔符,比如“###”,来分隔指令和上下文。
1 | ### Instruction ### |
特异性
要非常明确地说明你希望模型执行的指令和任务。提示词越具描述性和详细性,结果就会越好。事实上,在提示词中提供示例对于获得特定格式的期望输出非常有效。
1 | Extract the name of places in the following text. |
避免不精确性
通常来说,更具体、更直接的方式会更好。这就好比有效的沟通——越直接,传达的信息就越有效。
1 | Explain the concept prompt engineering. Keep the explanation short, only a few sentences, and don't be too descriptive. |
1 | Use 2-3 sentences to explain the concept of prompt engineering to a high school student. |
比起第一个例子,第二个例子更直接具体、简洁且切中要点,效果也更好。
做还是不做?
设计提示词时的另一个常见技巧是,避免说不要做什么,而是要说应该做什么。这能促使提示词更加具体,并聚焦于那些能让模型给出良好回应的细节。
提示技术
Zero-Shot Prompting
零样本提示意味着用于与模型交互的提示中不会包含示例或演示。零样本提示会直接指示模型执行某项任务,而不会提供任何额外示例来引导它。
Few-Shot Prompting
少样本提示可以作为一种技术来实现上下文学习,我们在提示中提供示例,以引导模型获得更好的性能。这些示例为后续我们希望模型生成响应的例子提供了条件。
下面是一些技巧,这些在后文也有提到
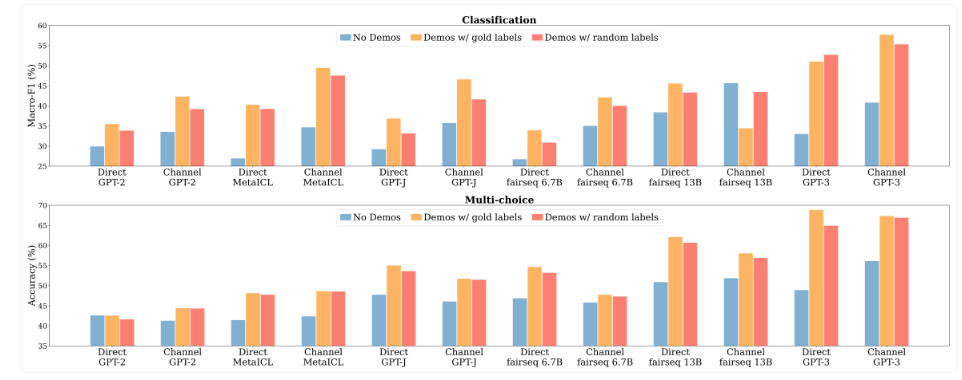
- “演示所指定的标签空间和输入文本的分布都很重要(无论这些标签对于个别输入是否正确)”
- 你使用的格式在性能中也起着关键作用,即使你只是使用随机标签,这也比完全没有标签要好得多。
- 其他结果表明,从标签的真实分布中(而非均匀分布中)选择随机标签也会有所帮助。
CoT
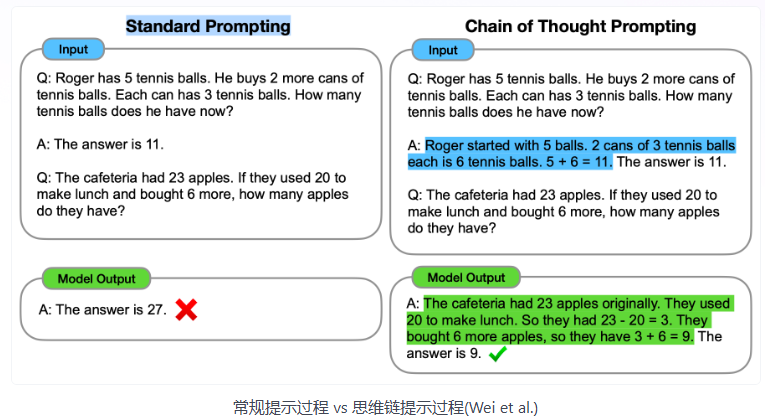
思维链(Chain-of-Thought,CoT)提示过程能鼓励大语言模型解释其推理过程
主要思想为通过向大语言模型展示一些少量的 exemplars,并在样例中解释推理过程,大语言模型在回答提示时也会显示推理过程。
模型从思维链提示过程中获得性能提升的方式与模型的大小成比例。小模型编写了不和逻辑的CoT并使用反而会更差
Zero-shot-CoT
在问题的结尾附加“让我们一步步思考。”这几个词,能让模型生成一个CoT并得到更准确的答案。
经过两轮询问,第一轮生成CoT,第二轮根据输入+此CoT进行输出,能得到更精准的答案。
提取步骤通常必须针对特定任务,使得零样本思维链的泛化能力不如它一开始看起来的那样强。
而且根据经验而言,“Step By Step”的加入有时可以有效地提高生成任务完成的长度
Auto-CoT
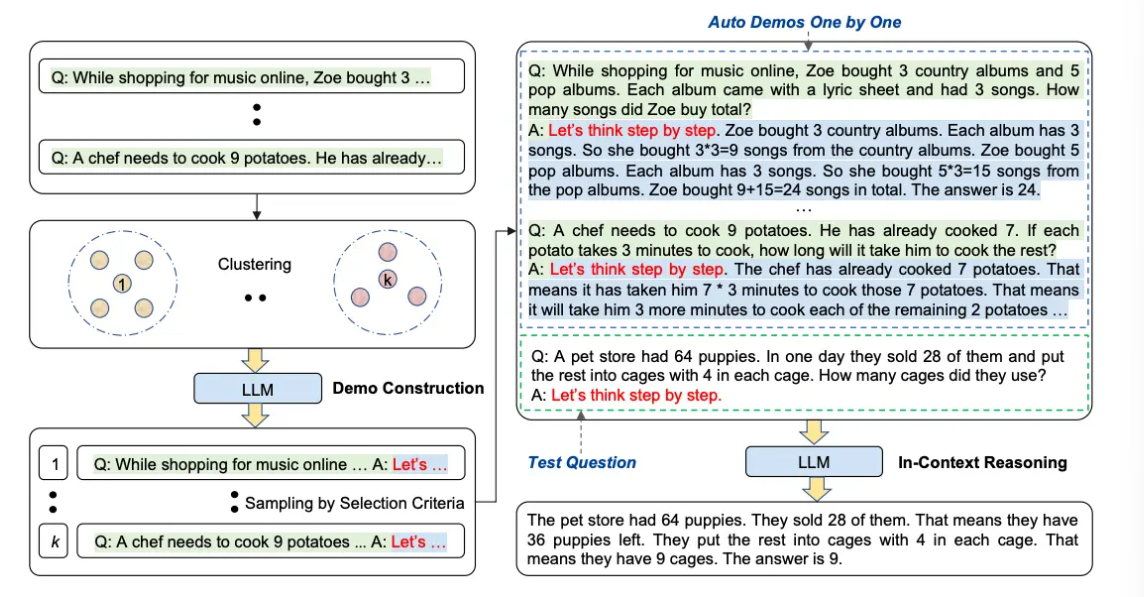
Automatic Chain-of-Thought 自动思维链
Auto-CoT包含两个主要阶段:
- Stage 1): 问题聚类:将给定数据集中的问题划分为若干个簇
- Stage 2): 演示采样:从每个聚类中选择一个具有代表性的问题,并使用带有简单启发式方法的零样本思维链(Zero-Shot-CoT)生成其推理链
简单的启发式方法可以是问题的长度(例如60个标记)和推理过程中的步骤数量(例如5个推理步骤)。这会鼓励模型使用简单且准确的示例。
元提示
Meta Prompting
元提示是一种高级提示技术,它关注任务和问题的结构及句法方面,而非其具体内容细节。元提示的目标是构建一种更抽象、结构化的与大型语言模型(LLMs)交互的方式,与传统的以内容为中心的方法相比,它更强调信息的形式和模式。
- (i) break down complex tasks or problems into smaller, manageable pieces; 把复杂的任务或问题分解成小的,可管理的片段。
- (ii) assign these pieces to specialized “expert” models with proper and detailed natural-language instructions;把这些片段带着正确且详细的指令分给特定的专家模型。
- (iii) oversee the communication between these expert models; 审查这些专家模型间的交互。
- (iv) apply its own critical thinking, reasoning, and verification skills throughout the process. 在这个过程中使用它们自己的思考、推理及验证。
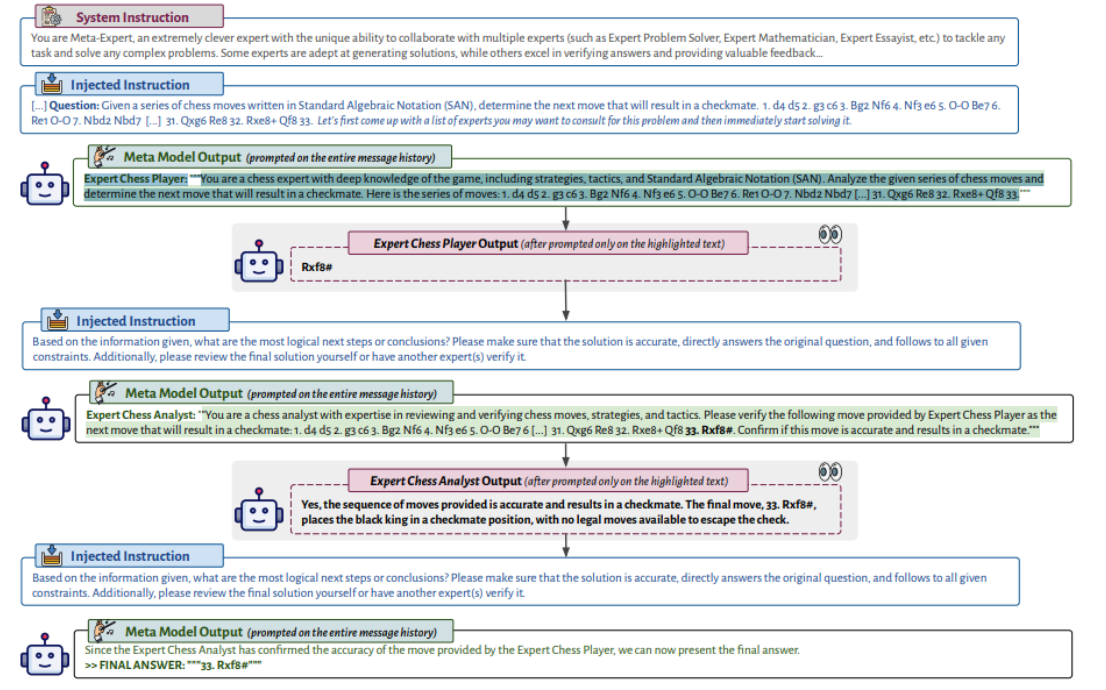
实现方式是通过 System Instruction 设置 Meta-Prompt, 在正常的交互 Prompt 里输入你的内容。
一个例子如下:
- 首先设置一个系统级的 Meta-Prompt
- 再输入正常的 Prompt
- 会输出 一个 Prompt 的交互结果,这个结果做为 Prompt 输入到 LLM 中
- 基于这个Prompt 的结果再次检查
- Meta-Prompt 会输出检查对应的 Prompt,这个结果结果做为 Prompt 输入到 LLM 中
- 基于这个 Prompt 的结果再次检查,得到最终的输出
以下是此算法的伪代码:
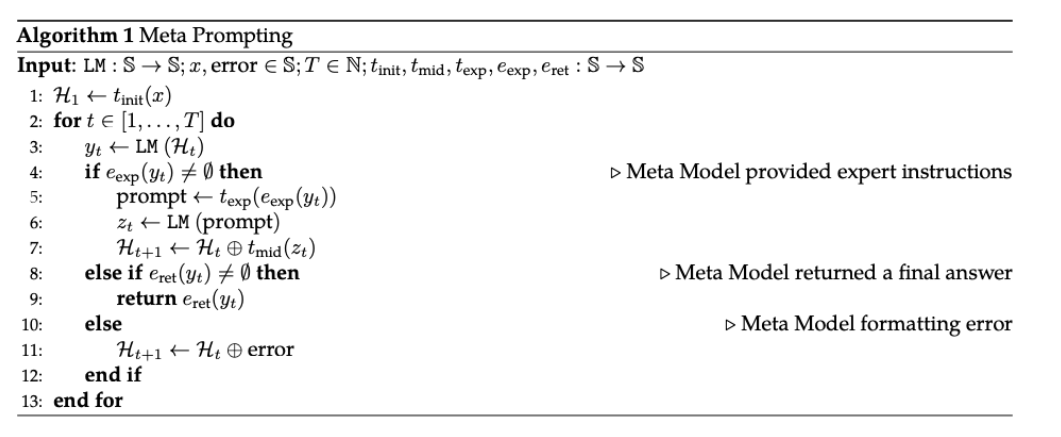
大意是有两个 LLM :一个作为指导加工 Prompt 的 Meta Model,其使用宏大且抽象的 Meta Prompt 当 System Instruction(如下面的例子),他接收整个过程中产生的信息;一个就是普通的 用于交互的 LLM 的,只接收自己和指导加工的Meta Model之间的通信信息。然后每次用户的输入在输入交互LLM 前,都要通过这个Meta Model的二次加工。
以下是一个正常的流程,和论文里带的Prompt
1 | 输入 Prompt,得到一个校准过的 Prompt,得到输出 |
1 | You are Meta-Expert, an extremely clever expert with the unique ability to collaborate with multiple experts (such as Expert |
自洽性
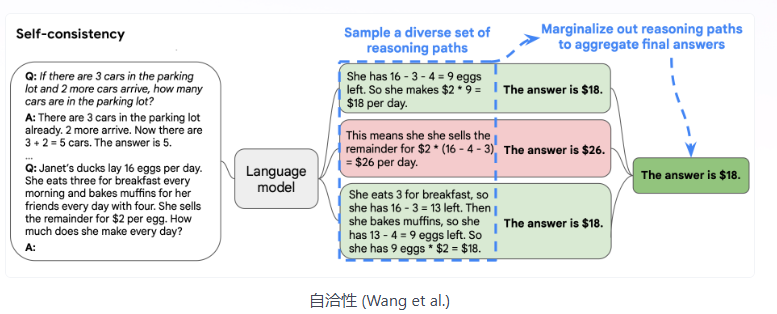
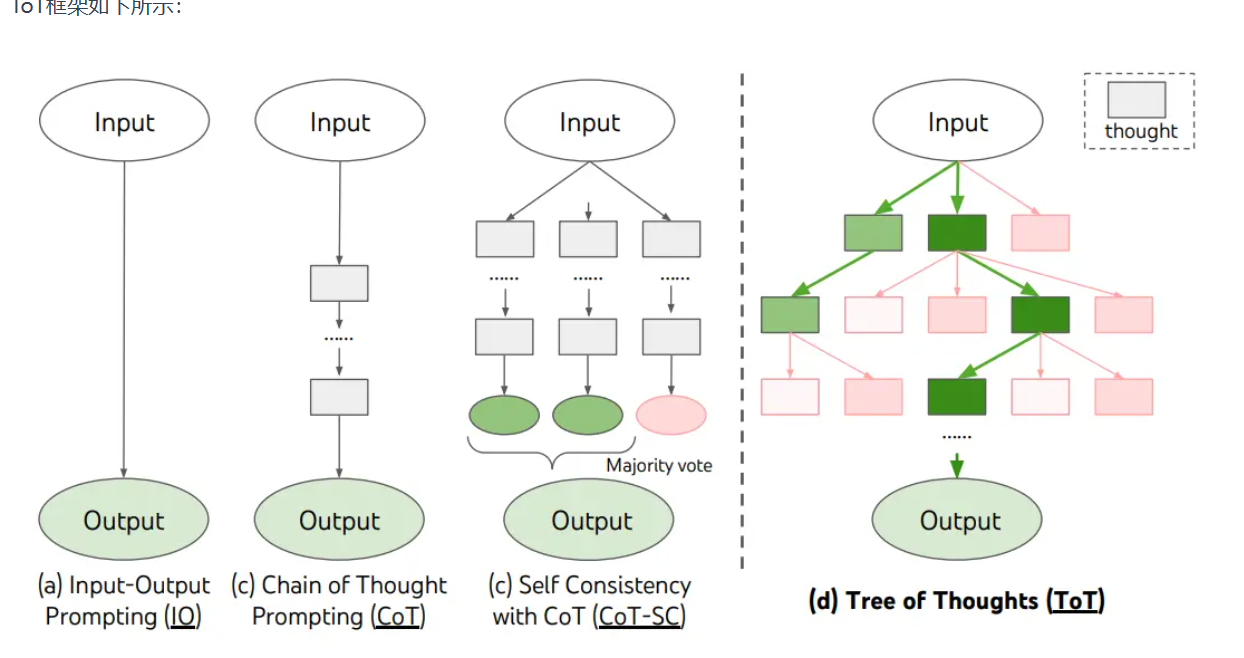
自洽性的方法为:生成多个思路链,然后取多数答案作为最终答案。
研究表明,自洽性可以提高算术、常识和符号推理任务的结果。即使普通的思路链提示被发现无效,自洽性仍然能够改善结果。
知识生成
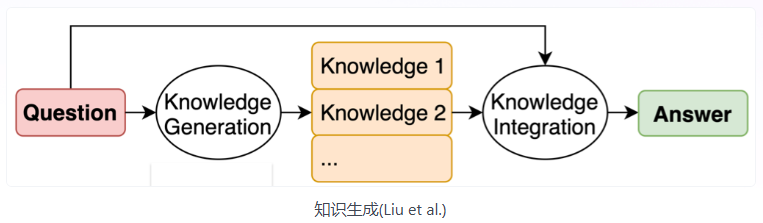
要求 LLM 在生成响应之前生成与问题相关的可能有用的信息。该方法由两个中间步骤组成,即知识生成和知识集成。
1 | 假设我们正在尝试回答问题“大多数袋鼠有 <mask> 肢体”。假设在知识生成步骤中,我们生成了 2 个知识(M=2): |
提示链
Prompt Chaining
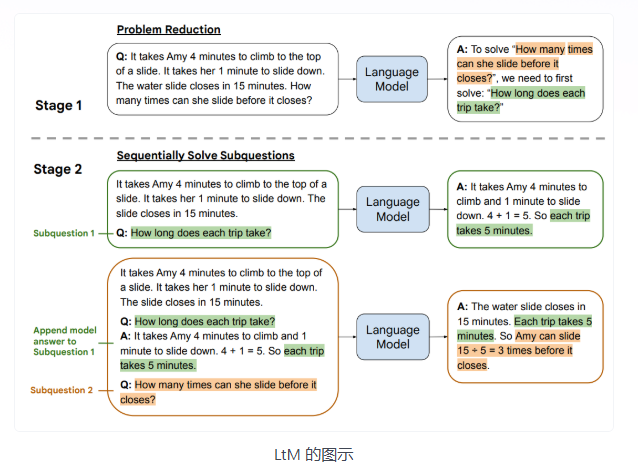
提示链的方法为:先让LLM将需要解决的问题分解成一组建立在彼此之上的子问题。接着一步步解决这些子问题,将当前步骤的子问题连带着先前子问题的回答输入到提示中,让LLM更好的回答当前的子问题。
提示的关键要素
研究发现在给出的 exemplar 中,就算有错误答案(random labels)对性能也几乎不受影响。
但是 labelsapce 也就是标签空间的范围/类型很重要(给模型知道该输出什么样的东西),而且示例里的标签分布最好要和真实情况一致(真是评论里好坏是8:2开,实例里最好也8:2开)
样本的格式非常重要
思维树
Tree of Thoughts (ToT)
思维链树(ToT)维护着一个思维树,其中的“思维”指的是连贯的语言序列,这些序列是解决问题过程中的中间步骤。
这种方法使大语言模型(LM)能够通过审慎的推理过程,对解决问题过程中通过中间思维所取得的进展进行自我评估。
然后,将大语言模型生成和评估思维的能力与搜索算法(例如广度优先搜索和深度优先搜索)相结合,从而实现带有前瞻和回溯功能的系统性思维探索。
使用思维链(ToT)时,不同的任务需要确定候选答案的数量以及思路/步骤的数量。例如,正如论文中所展示的,24点游戏被用作一项数学推理任务,它需要将思路分解为3个步骤,每个步骤都包含一个中间等式。在每个步骤中,会保留最佳的5个候选答案。
RAG
Retrieval Augmented Generation 检索增强生成
对于更复杂且知识密集型的任务,可以构建一个基于语言模型的系统,该系统能够访问外部知识源来完成任务。这有助于提高事实一致性,增强生成响应的可靠性,并有助于缓解“幻觉”问题。
检索增强生成(RAG)将信息检索组件与文本生成模型相结合。RAG接收一个输入,并从给定来源(例如维基百科)中检索一组相关/支持性文档。这些文档会作为上下文与原始输入提示拼接在一起,输入到文本生成器中,由其生成最终输出。RAG可以进行微调,其内部知识能够以高效的方式修改,且无需重新训练整个模型。
预训练的序列到序列模型被用作参数化记忆,维基百科的密集向量索引被用作非参数化记忆(通过神经预训练检索器访问)。以下是该方法的工作概述:
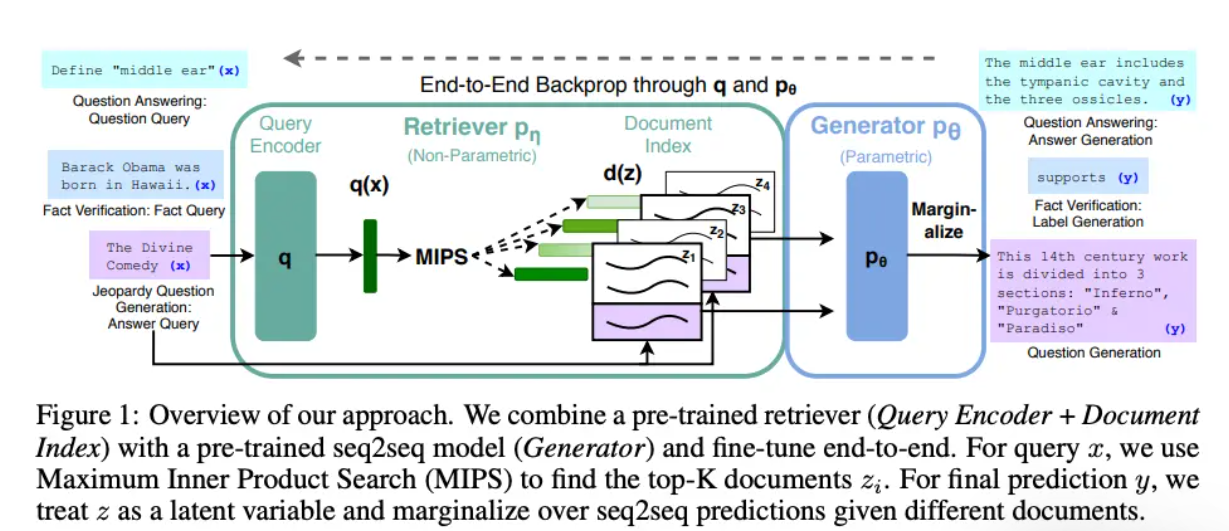
大意是通过点积相似度去寻找语料库里前K大的预料,然后再接入原先的prompt,实现RAG
Automatic Reasoning and Tool-use (ART)
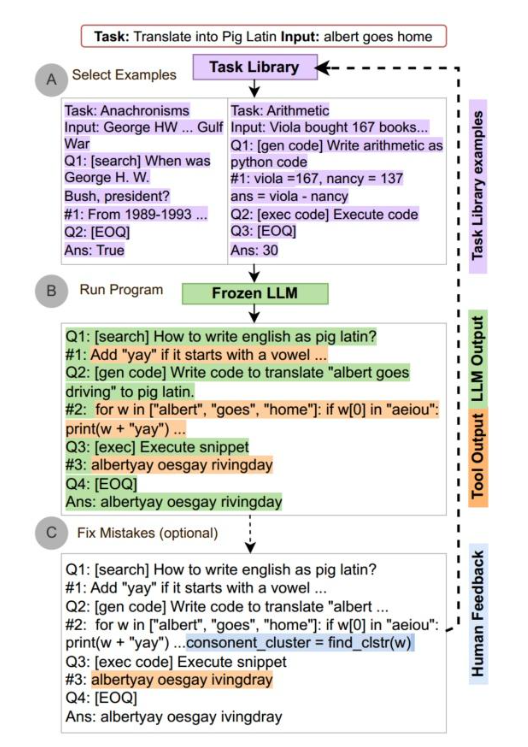
自动推理和工具使用(ART),是一个为新任务实例自动生成分解(多步推理)的框架。框架还能在各个步骤中选择和使用最合适的可用工具(如搜索引擎和代码执行)。
| 阶段 | 核心操作 | 详细说明 |
|---|---|---|
| 1. 任务初始化 | 输入新任务 | 用户提供待解决的复杂问题(如数学推理、科学问答等) |
| 2. 演示选择 | 检索任务库 | 从预定义的任务库中选择相关的多步推理 + 工具使用演示,作为模型的参考模板 |
| 3. 推理生成 | 模型自驱动推理 | 冻结 LLM 开始生成推理步骤,按以下规则执行:- 正常生成推理内容- 检测工具调用信号(如 “需要计算…”、”查询…”) |
| 4. 工具调用 | 暂停生成 + 工具执行 | 模型触发工具调用时:① 暂停文本生成② 调用外部工具(计算器、搜索引擎、数据库等)③ 获取工具输出结果 |
| 5. 结果整合 | 工具输出→推理上下文 | 将工具返回的结果无缝插入推理流程,作为下一步推理的前提条件 |
| 6. 推理恢复 | 继续生成推理 | 模型基于整合后的上下文,继续完成剩余推理步骤,直至得出最终答案 |
| 7. 人工优化(可选) | 错误修正 + 库更新 | 若结果存在偏差:- 人工修正推理步骤中的逻辑错误- 添加新工具到工具库- 更新任务库中的演示案例- 重新执行推理流程 |
Automatic Prompt Engineer (APE)
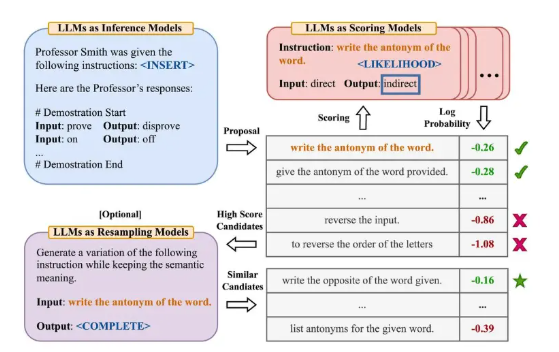
APE 通过 “生成 - 评估 - 选择” 的循环机制,将提示词工程从人工试错转变为系统化自动优化,显著降低了提示词设计门槛,同时提升了 LLM 在各类任务上的性能上限。它特别适合需要快速适配新任务或寻找超越人工直觉的最佳提示词的场景。
APE的核心思路是:从候选集中选出好的prompt,再在好的prompt附近进行试探性地搜索。
APE 的运行遵循以下三个关键步骤,形成完整的提示词优化闭环:
- 指令生成(Candidate Generation)
输入:任务的输出示例(demonstrations),无需输入指令
模型:使用一个强大的 LLM 作为 “推理模型”
过程:模型观察输出示例,反向生成可能产生这些输出的指令候选
输出:一批多样化的自然语言指令(如 10-100 条),每条都是解决该任务的潜在提示词
- 指令执行与评估(Execution & Evaluation)
执行:将生成的候选指令分别输入目标模型(需要优化的模型,如较小的 LLM)
评估:计算每条指令在任务上的性能分数(如准确率、F1 值)
关键:评估指标需与任务目标高度相关(如数学题用计算正确率,分类任务用 F1)
- 最佳指令选择(Selection)
基于评估分数对所有候选指令排序
选择分数最高的指令作为最终优化提示词
可选择保留前 N 条最佳指令,用于集成或进一步优化
ReAct Prompting
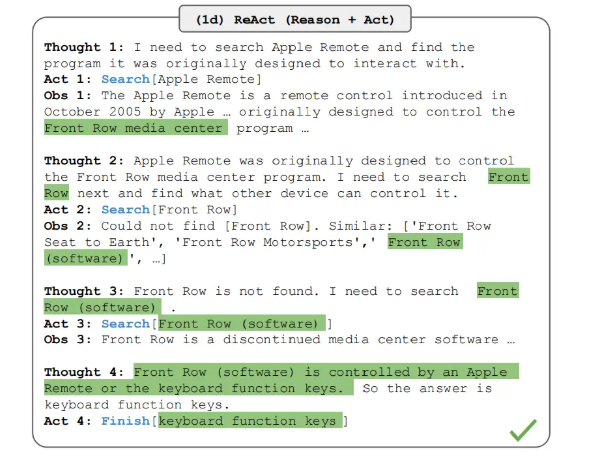
其核心思想是通过 “思考-行动-观察”(Think-Act-Observe,TAO)循环,使语言模型能够动态生成推理步骤、调用外部工具,并根据环境反馈迭代优化决策,从而解决复杂任务。
TAO 循环具体包括以下步骤:
2.1 推理(Think)
TAO 循环的起点是基于初始任务或上一轮观察结果的推理过程。智能体通过语言模型生成推理轨迹,分析任务目标、分解子问题、规划下一步行动。推理过程需明确:是否需要调用工具?调用哪个工具?输入参数是什么?例如,面对天气查询问题,推理可能是:“我需要先确定 2024 年金球奖得主是谁(可能需要搜索),再查询其出生地,最后获取该地当前天气。”
2.2 行动(Action)
根据推理结果,智能体生成工具调用指令(如 API 调用、数据库查询、物理操作),与外部环境交互。行动需遵循预设格式(如函数名+参数),例如:search("2024 FIFA Ballon d'Or winner") 或 weather_api("Paris")。
2.3 观察(Observation)
行动执行后,智能体接收外部环境的反馈结果,形成观察数据。观察可能是工具返回的原始数据(如搜索结果、API 响应)、环境状态变化(如传感器数据)或错误信息(如“API 调用失败”)。例如,搜索“2024 年金球奖得主”后,观察结果可能是“梅西(Lionel Messi)”。
2.4 循环迭代
观察结果作为新的输入,触发下一轮“思考-行动-观察”循环,直至任务完成(如生成最终答案)或达到最大迭代次数。
关键特性:推理轨迹仅影响智能体内部状态(无环境副作用),而行动直接与外部交互(如调用搜索工具、控制机械臂),两者通过观察形成闭环。这种设计使智能体既能灵活规划,又能通过工具弥补内部知识局限。